Memory - Address, Contiguous allocation, MMU
Memory #
memory 관리는 physical address를 갖는 메모리 공간에서 여러 개의 프로세스를 어떻게 같이 돌릴 것인가에 대한 관리다. 그렇다면 physical address는 무엇일까? 한마디로 메모리 공간에서의 위치다.
우리는 메모리를 잡아먹는다, 메모리 몇이야? 라는 말을 많이 들어봤을 것인데, 익히 들어 알고있는 RAN이란 용어도 메모리에 관련된 것이다. 추상적으로 프로그램을 실행시키면 실행에 필요한 데이터들이 메모리에 올라가면서 실행되는 것이구나라고 생각할 수 있다.
프로그램의 실행은 곧 프로세스의 컨텍스트가 메모리에 올려지고, cpu에 의해서 실행되는 것을 의미한다.
Address Binding #
cpu가 프로세스의 작업을 실행하기 위해 논리적 주소만으로는 실제 메모리의 주소를 알 수 없기 때문에 논리 주소와 위에서 언급했던 물리적 주소를 매핑해주는 작업이 필요하고 이 작업을 주소 바인딩이라고 한다.
논리적 주소?
cpu에 의해 가상으로 생성되는 주소체계를 논리적 주소라고 한다. 이 논리적 주소를 물리적 주소와 매핑해서 사용하게 되는데, 여기서 논리적 주소와 물리적 주소를 매핑해주는 장치가 mmu이다. 논리적 주소는 추상화, 메모리 보호, 가상 메모리와 같은 이점으로 꼭 필요한 개념이다.
다시 돌아와서, 주소 바인딩 방식은 아래와 같이 세 가지가 존재한다.
- 컴파일 타임 바인딩
- 로드 타임 바인딩
- 실행시간(런타임) 바인딩
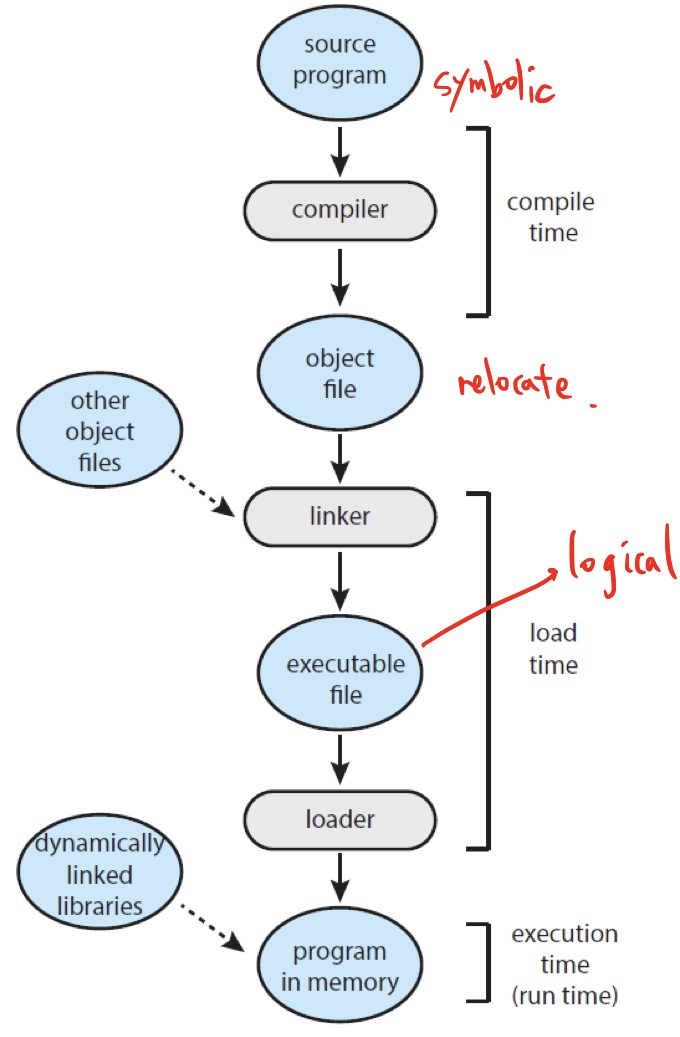
위 세 가지 주소 바인딩의 차이는 물리적 주소가 언제 결정되느냐에 따라 다르다.
Compile Time Binding #
컴파일 타임 바인딩은 말 그대로 컴파일 시점에 물리적 메모리 주소가 결정되는 주소 바인딩 방식이다.
컴파일 과정은 컴파일 또는 어셈블러로 목적 코드를 만드는 과정이다.
컴파일 타임이라는 단어를 쉽게 말하면 프로그램 내부에서 사용하는 주소와 즉, 논리적 주소와 물리적 주소가 똑같다고 생각하면 된다.
이 방법은 많이 사용되는 방식은 아니다. 이유는 현재 우리가 쓰는 컴퓨터는 한 가지 프로세스만 실행시키지 않기 때문이다.
현재 컴퓨터 상황도 모르고 물리적 주소를 사용하면 다른 프로세스가 실행되면서 차지하고있는 메모리에 덮어 씌울 수도 없는 노릇이다.
실질적으로 메모리에 이 프로세스를 올린다! 라는 방식인데 불가능하다.
Load Time Binding #
로드 타임 바인딩은 프로세스의 실행이 시작될 때 물리적 주소를 결정한다.
위에서 잠깐 설명한 논리적 주소를 사용하는데, 프로세스 내부의 메모리 시작을 0번지에서부터 해서 상대 주소(논리적 주소) 프로세스 안에서 사용하는 메모리 주소를 프로세스 전체를 로딩할 때 이 프로세스가 로딩되는 위치에 따라 물리적 주소를 매핑하는 것이다.
그렇다면 로드 타임 바인딩은 어떤 문제가 있을까?
프로세스가 시행될 때마다 물리적 주소를 매핑해주는데, 바꿀 때 마다 매핑을 새로 해주면 메모리를 로딩할 때 시간이 오래 걸리는 문제가 발생한다. 프로그램을 실행할 때 코드 명령어를 저장하는 segment가 굉장히 많은데, 하나하나 실행할 때마다 계산을 해줘야하기 때문이다.
위 두 가지 바인딩 방식의 단점을 보완하기 위해 나온 방식이 런타임 바인딩이다.
Runtime Binding #
말 그대로 프로그램이 실행한 후에도 물리적 주소가 변경될 수 있는 바인딩 방식이다.
실행 시간 바인딩에서는 cpu가 주소를 참조할 때마다 해당 데이터가 물리적 주소의 어느 위치에 있는지 주소 매핑 테이블을 이용해서 바인딩을 확인한다. 또한 위의 로드 타임 바인딩에서 설명했었듯이, 세그먼트가 굉장히 많고 하나하나 실행할 때마다 계산을 해줄 수 있는 경우 software가 아닌, hardware가 작업을 수행해주는데, 이 hardware가 바로 MMU이다.
Contiguous allocation #
MMU를 알아보기 전에 메모리 구성과 분할 방법에 대해서 간단하게 알아보자
메인 메모리는 운영체제뿐 아니라 여러 프로세스를 실행시킬 수 있어야 한다.
메모리는 일반적으로 두 개로 나누어지는데, 하나는 메모리에 올라가 있는 운영체제를 위한 것이고 하나는 사용자 프로세스를 위한 것이다.
때문에 컴퓨터를 잘 사용하려면 가장 효율적인 방법으로 메인 메모리를 분할하고 할당해줘야 한다.
이 방식들 중에서 요즘에는 쓰이지 않는 연속 메모리 할당 방식에 대해서 알아보겠다.
운영체제는 메모리 양 끝에 위치할 수 있지만 보통은 낮은 메모리에 위치한다. 그 이유로는 인터럽트 벡터가 있다.
인터럽트 벡터는 대부분 낮은 메모리에 위치하기 때문에 운영체제는 하위 메모리에 위치시키는 것이 보통이고 때문에 운영체제는 하위 메모리에 위치해있다고 가정하고 설명을 이어나가 보겠다.
보통 여러 프로세스가 동시에 메모리에 적재되어 있는 것이 효율적이기 때문에 우리는 입력 큐에서 대기중인 프로세스들에게 메모리르 어떻게 효율적으로 할당해야하는가에 대한 고민을 계속한다. 위와 같은 연속 메모리 할당 시스템에서 프로세스는 연속된 메모리 공간을 차지한다.
정리해보면 연속 메모리 할당이란 논리적 주소가 연속적이면 물리적 주소도 연속적으로 할당된다라는 것이다.
그렇지만 요즘엔 fragmentation에 관한 문제로 자주 사용되지 않는다. paging이 나온 이유기도 하다.
MMU #
위에서 언급했듯 프로세스의 논리적 주소는 실행 시점에 어떠한 하드웨어에 의해서 물리적인 주소 공간으로 매핑되는데, 이때 relocation register와 limit register라는 하드웨어가 논리적 주소와 물리적 주소로 매핑에 사용되며, mmu register는 cpu 코어 안에 탑재되어 이 두 가지 레지스터의 값을 더하여 논리적 주소로부터 물리적 주소 공간을 지정해주는 레지스터를 말한다.
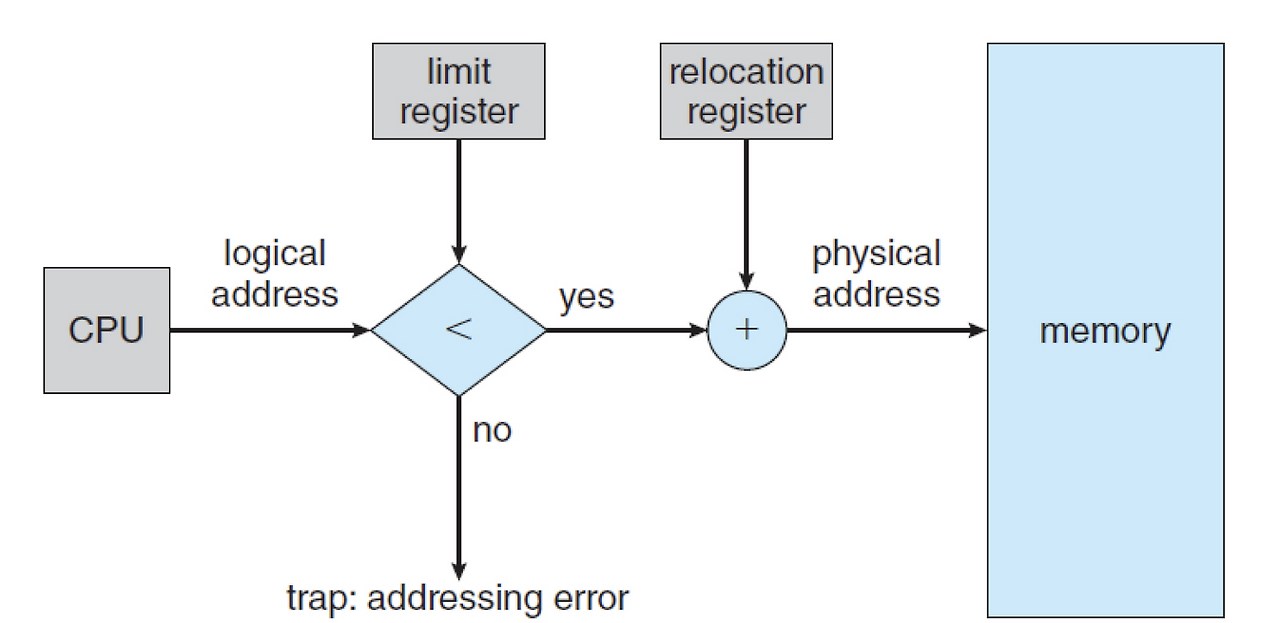
MMU 방식에서는 기준 레지스터 값 + 논리적 주소 값을 통해서 주소 바인딩을 한다.
만약 해당 값이 해당 프로세스의 주소 범위를 넘어가게 된다면 어떻게 될까? 프로세스가 접근해서 안되는 영역을 접근할 가능성이 생긴다 이런 문제점을 방지하기 위해 memory protection을 적용한 Limit Register를 사용하는 것이다.
한계 레지스터에는 최대 논리적 주소 값을 저장하고 cpu가 논리적 주소를 요청할 때마다 한계 레지스터 값보다 작은 값인지 검사하게 되고 만약 더 크면 memory protection fault를 발생시킨다.
그러면, 프로세스는 고유한 주소 공간을 가지고 있고, 논리적 주소 값은 프로세스마다 독립적으로 할당된다고 했다. 예를 들어 프로세스 A에도 100번 논리주소가, 프로세스 B에도 100번 논리 주소가 있을 수 있다는 것이다. 그렇다면 프로세스 A의 100번 논리 주소에 매핑되는 실제 물리적 주소와 프로세스 B에 매핑되는 실제 물리적 주소는 다를 것이다.
따라서 mmu기법에서는 context switching이 일어날 때 마다 relocation register의 값을 바뀌는 프로세스에 해당되는 값으로 재설정을 해줘야한다.