모델 아키텍처별 서빙 플레이북
새로 나온 모델의 config.json과 모델 카드만 보고 서빙 설계를 스스로 유도하는 것을 할 수 있게 하는 역량 습득을 목표로 둘 것이다.
- 계열 판정: 모델이 GQA인지 MLA인지 DSA인지 하이브리드인지 필드 몇 개로 가려낼 수 있어야한다
- KV 캐시 규모 파악: 계열에 따라 손으로 계산할지 실측할지 정하고 그 값에서 동시 사용자 수를 역산할 수도 있다
- 병렬화를 고른다: TP? EP? DP어텐션을 킬지 아키텍처와 트래픽 규모에서 결정할 수 있어야한다.
- 하드웨어 적합성 검증: 이 모델이 내 GPU에 도는가 등 도는데 최적경로인지등을 판단할수있어야한다/
- 증상에서 원인 역추적: 모델이 도구를 안씀, 메모리가 빨리참. 같은 현상을 잘 트래킹해서 해결한다.
전제 지식 #
- 트랜스포머 기본 구조 (레이어, 어텐션, FFN)
- KV 캐시가 왜 존재하는지
- 프리필과 디코드 차이
- 병렬화 TP PP EP DP
- 양자화 기본 개념
배울 것 #
- MHA, MQA, GQA 차이와 GQA가 표준이 된 이유
- MLA가 압축하는 대상
- 희소 어텐션과 인덱서의 동작
- 선형 어텐션의 상태가 KV 캐시와 다른점
- MoE의 라우팅과 전문가 병렬
- 컴퓨트 능력(sm_XX)이 배포에 제약이 되는이유
아키텍처 판단 #
모델을 대규모로 서빙하다보면 다음과 같은 상황의 문제들을 해결해야한다.
- 컨텍스트 부족: 128k로 시작했는데 고객이 계약서 전문을 넣기 시작함 -> 1M 지원 모델로 옮겨야댐, 근데 그 모델은 대개 다른 계열
- 원가가 안 맞음: 트래픽이 열 배로 늘어 gpu 증설 견적이 나왔는데.. ㅈㄴ비쌈 -> 활성 파라미터가 작은 MoE로 옮기면 증설 없이 감당이 가능하다.
- 품질이 부족: 코딩 에이전트의 실패율이 목표를 못 맞춘다.
컨텍스트 때문이면 KV 캐시가 최우선이고 원가 때문이면 전문가 병렬설정이 최우선 이런 판단을 내릴 수 있어야한다, 그냥 더 좋은 모델을 바꾼다 식의 접근을하면 무엇을 확인하고 최적화할지를 정할 수 없기에
일단 모델 서빙을 해야하는 상황들을 가정해보면서, 고민을 해보자.
새 서비스를 시작해 모델을 새로 서빙할때 #
GPU는 있고 예산이 확정된 상태에서 그 위에 무슨 모델을 올릴지 결정해야하는 상황부터 보겠다.
흔한 실수는 벤치마크 리더보드 부터 뜯어보고 SWE-bench 점수가 제일 높은 모델을 고르고나서 GPU에서 안뜬다는걸 알게되어 절망하는 상황이다.
가진하드웨어를 보고 시작해 후보를 잘라내는걸로 시작하자.
SM #
아래에서 sm_89같은 표기가 나오는데 gpu 세대를 가리키는 번호다.
CUDA 컴퓨트 능력(compute capability)라고 부르고 커널이 어느 하드웨어에서 도는지 이 번호로 가른다.
sm_86    Ampere 소비자용 (RTX 3090)
sm_89    Ada (RTX 4090)
sm_90    Hopper (H100, H200)
sm_100   Blackwell 데이터센터 (B200, B300)
sm_120   Blackwell 워크스테이션 (RTX 5090, RTX PRO)
번호가 크다고 아래 세대를 다 포함하는건 아니고 sm_100용으로 짠 커널이 sm_120에서 안도는 경우가 있다.
RTX 4090 두 장 (sm_89)
  DSA 계열 탈락 — 희소 어텐션 커널이 sm_90 이상에만 존재
  대형 MoE 탈락 — 48GB에 안 들어감
  → GQA dense 20~30B급, 또는 소형 하이브리드

H200 여덟 장 (sm_90, 1,128GB)
  대부분의 계열이 가능
  → 워크로드로 좁혀야 함

B300 랙 (sm_100)
  NVFP4 체크포인트가 있는 계열이 유리
  없는 모델은 FP8로 떨어져 메모리 이점을 못 씀
NVFP4는 4비트 부동소수점 형식으로 가중치와 KV 캐시를 원소당 4비트로 저장하는데 4비트로 표현 가능한 값이 16개 뿐이라 그대로는 못쓴다. 그래서 값 16개를 한 블록으로 묶고 블록마다 스케일 값을 따로 둔다. 실제 값은 4비트 값에 그 스케일을 곱한것이고 신경망 가중치는 국소적으로 비슷한 크기를 가지게되므로 블록단위 축척을 맞추면 16단계로도 그 블록의 분포를 잘 근사한다.
FP8과 비교하면 이렇다.
             메모리        텐서 코어 처리량      하드웨어 지원
FP8          1/2 (BF16 대비)   2배               Hopper 이상
NVFP4        1/4               4배               Blackwell 데이터센터만
메모리가 절반이면 같은 gpu에 두 배의 kv 캐시가 들어가고 그만큼 동시성이 늘어난다 처리량이 두배면 프리필이 그만큼 빨라진다. B300을 산 이유가 보통 그렇다.
문제는 아무 모델이나 NVFP4로 돌릴 수 없다는 것이고 모델을 NVFP4로 양자화한 체크포인트가 따로 배포되어야하고 없으면 직접 만들어야 하는데 보정 데이터와 검증이 필요한 작업이다 체크 포인트가 없는 모델은 FP8로 떨어지고 그러면 sm_100 하드웨어를 사놓고 sm_90에서 낼 수 있는 성능만 쓰게 된다/
그래서 B300랙이라면 후보 모델이 NVFP4 체크포인트가 공개되어있는지 먼저 본다. nvidia/GLM-5.2-NFFP4 처럼 이름이 표시되는 경우가 많다.
하드웨어로 후보가지치기를 했으니 다음 처리해야하는 요청의 성향 즉 워크로드를 파악해서 갈라야한다.
20만 토큰 문서를 자주 다룬다
-> DSA or Hybird, GQA는 KV 캐시가 감당이 안됨

대화가 짧고 동시 사용자가 많음
-> GQA dense로 충분함, 굳이 복잡한 계열을 쓸 이유 없음

이미지가 들어온다
-> 얼리퓨전 계열만, 나머지는 애초에 못 함
여기까지 오면 후보 서너개로 줄고 그때 벤치마크 점수를 비교하며 ㄴ된다.
남이 만든 설정을 넘겨받아 운영 #
모델도 하드웨어도 이미 정해진채로 서빙되고있고 이를 개선한다고 했을때, 실무에서 가장 잦고 정할 것은 없는 대신 왜 이렇게 되어있는지 모르는채로 굴리게 된다.
python3 -m sglang.launch_server \
  --model nvidia/GLM-5.2-NVFP4 \
  --tensor-parallel-size 8 \
  --quantization modelopt_fp4 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --chunked-prefill-size 16384 \
  --mem-fraction-static 0.80
여기서 확인해야할것들 몇가지 체크리스트 뽑으면
--kv-cache-dtype이 왜 없지--attention-backend는 왜 안잡혀있지- 파서이름이
glm47glm45이게뭐지 --mem-fraction-static이게 왜 0.80로 했을까
이런거 모르면 두 종류의 사고가 나는데 하나는 필요한걸 지웠다가 기능이 조용히 죽고 다른 하나는 플래그 추가했다가 엔진의 자동 최적화를 덮어쓰인 경우다.
이런거 잘못하면 모델이 뜨지않고 죽어버리거나 떴는데 느리거나 MoE모델에 전문가 병렬을 안켜면그냥 도는데 다만 전문가 가중치가 모든 gpu에 복제되어 kv캐시공간이 줄고 동시사용자수가 절반이하로 떨어져버린다거나 조용히 손해를 보는 dsa모델에 fp8을 kv cache dtype에 지정해 에러없이 성능이 그럭저럭 나오는, 최적 정밀도를 고르던 엔진의 판단을 덮어써버린다거나 걍 안좋아진다.
이제 하나씩 알아보자. KV캐시의 모양이든 병렬화 전략, 커널 요구사항 캐싱 계층의 호환성, 소프트에웨어 버전 게이팅등 신경써야할 게 많다.
어텐션 계열별 서빙 - GQA #
GQA의 대표 모델은 Qwen3.6-27B, Qwen3계열 dense, Llama 계열이다.
GQA(Grouped-Query Attention)는 어텐션 헤드 여러개가 K와 V를 한 벌씩 나눠 쓰게 만드는 방식이다.
헤드마다 따로 저장하던것을 그룹 단위로 공유해서 KV 캐시를 4분의 1에서 8분의 1로 줄인거다.
MHA   [헤드1:K,V][헤드2:K,V][헤드3:K,V][헤드4:K,V]    K,V 4벌
GQA   [헤드1,2 : K,V      ][헤드3,4 : K,V      ]    K,V 2벌
MQA   [헤드1,2,3,4 : K,V                       ]    K,V 1벌
2026 현재 가장 널리 쓰이는 방식이고 뒤에 나올 세 계열 전부 이 방식이 남긴 한계를 각기 다른방향으로 해결했다.
일단 GQA가 왜 필요했는지부터 알아보자
KV 캐시가 커지는 이유 #
어텐션은 여러 개의 헤드를 나뉘어 병렬 수행 된다 헤드마다 다른 관점으로 문장을 본다.
문법을 보는 헤드, 지시 대상을 추적하는 헤드 이처럼 역할이 갈리게 된다.
각 헤드는 Q(찾는것) K(가진것) V(실제내용) 세 벡터를 만들고 Q, K의 내적으로 점수를 매겨 높은쪽의 V를 가져온다.
생성 단계에서는 앞서 계산한 K V를 저장해두고, 500번째 토큰을만들때 499개를 다시 계산하는것을 방지해 미리 캐시해두고 저장해둔다. 이게 KV 캐시
원래 방식인 MHA는 헤드마다 K와 V를 따로 가진다.
KV 캐시 = 2 × 레이어 수 × 헤드 수 × 헤드 차원 × 시퀀스 길이 × 바이트
          ↑                ↑
          K와 V             헤드마다 별도
헤드가 32개면 32벌을 저장하고, 레이어가 48개면 그게 48번 반복된다. 숫자를 넣어보면
27B급 모델, MHA 32헤드, 헤드차원 128, 48레이어, FP8

토큰당 KV = 2 × 48 × 32 × 128 × 1 = 393,216 바이트 ≈ 384 KB
32K 컨텍스트 사용자 한 명 = 384 KB × 32,768 ≈ 12.6 GB

H200 한 장(141GB)에서 가중치 27GB를 빼면 114GB
→ 동시 9명
동시 9명정도만 받을수있는 서비스가 되는것이다.
MQA가 실패한 지점 #
가장 단순한 해법은 KV를 한벌만 두는건데 쿼리 헤드 32개는 유지하되 참조하는 KV를 전부 공유하는것 이것이 MQA Multi Query Attention 이다.
KV캐시가 32분의 1이 된다 위 계사넹서 12.6GB -> 0.39GB까지 줄고 동시 사용자는 290명이 된다.
그러나 메모리 문제는 풀렸지만 문제는 품질이 떨어지는 것이다. 헤드마다 다른 관점으로 바라보라고 만든 구조인데 참조할 정보를 하나로 통일해버리니 관점의 다양성이 줄어들게 된 것이다.
그룹으로 묶음 #
GQA는 그래서 극단적으로 다공유하지말고 쿼리 헤들르 그룹으로 묶고 그룹마다 KV를 한 벌씩 둔다. 쿼리 32개에서 KV 8개면 4개가 하나를 공유하고 캐시는 4분의 1이 된다.
품질 손실이 거의 없는 이유는 그룹 안의 쿼리 헤드들이 원래도 비슷한 것을 보는 경향이 있기 때문이다. 완전히 다른 관점의 헤드끼리 강제로 묶는게 아니라 적당한 크기로 나누면 각 그룹이 자기 관점을 유지한다.
MQA는 32개를 하나로 뭉쳐 이 성질을 깨뜨렸고, GQA는 4개씩 묶어 보존했다.
방식     KV 캐시    품질       채택
─────────────────────────────────────
MHA      기준       최고       초기 모델
MQA      1/32       하락       일부 모델
GQA      1/4~1/8    거의 유지  현재 표준
모든 레이어가 같은 구조라 KV 계산을 해보면
Qwen3.6-27B (레이어 48, KV 헤드 8, 헤드 차원 128, FP8)

토큰당 KV = 2 × 48 × 8 × 128 × 1 = 98,304 바이트 ≈ 96 KB
32K 컨텍스트 사용자 한 명 ≈ 3.1 GB
114 GB 여유 → 동시 36명
병렬화를 한다면 TP만 쓸것이다 일단 전문가가 없으니 EP는 선택지가 아니고 어텐션 표준이라 DP 어텐션의 이점도 없다.
나누는 방식은 네가지가 있는데 GQA dense는 셋이 탈락한다.
EP    전문가를 나누는 방식인데 dense 모델에는 전문가가 없음
DP    어텐션만 따로 떼는 이유는 압축된 KV의 복제를 막기 위함인데
      GQA는 압축을 안 하므로 떼어낼 이유가 없음
PP    레이어를 깊이로 나눔. 통신은 적지만 GPU가 차례로 일해
      요청 하나의 속도가 안 빨라짐. 추론에서는 거의 안 씀
TP크기는 지연 요구사항으로 설정할 수 있는데, 실측으로는 TP8 인스턴스 하나보다 TP2 인스턴스 넷이 처리랑이 34%더 높았지만 토큰간 간격은 42%정도 나빴다.
TP8 인스턴스 하나    여덟 장이 한 팀. 요청 하나를 여덟 장이 나눠 처리
TP2 인스턴스 넷      두 장씩 네 팀. 각 팀이 다른 요청을 처리

실측하면 TP2 넷이 처리량 34% 높고 첫 토큰까지의 시간도 29% 짧습니
간격 기준이 빡빡하면 TP를 크게 잡고, 여유가 있으면 TP를 줄이고 복제를 늘리자.
커널과 캐싱은 표준 경로로 하드웨어 세대별 자동 선택으로 맡기면 되고 젒두사 캐싱도 그대로 작동한다. 블록해시가 같으면 kv가 비트 단위로 동일하니까.
양자화로 kv캐시를줄이는 시도도할 수 있다 .
TP2, FP8 기준
  토큰당 KV = 2 × 48 × 8 × 128 × 1 = 96 KB
  사용자 한 명 ≈ 3.1 GB
  두 장 282 GB에서 가중치 27 GB를 빼면 255 GB
  → 동시 82명
여러 요청이 같은 시스템 프롬프트로 시작하면 그 부분 kv는 매번 같다. 한 번 계산해두고 재사용하면 프리필을 건너뛸수있으며이게 접두사 캐싱이다.
GQA에서는 이게 그냥 된다 블록 해시가 같으면 kv가 비트 단위로 동일하기 때문이다 뒤에 나온 계열들은 여기서 조건이 붙는다.
커널도 신경쓸것이 없다 표준 어텐션이라 엔진이 하드웨어 세대에 맞춰 자동으로 고른다.
python -m sglang.launch_server \
  --model-path Qwen/Qwen3.6-27B \
  --tp-size 2 \
  --quantization fp8 --kv-cache-dtype fp8_e5m2 \
  --chunked-prefill-size 4096 \
  --enable-metrics
GQA 한계 #
dense 구조는 파라미터가 커질수록 토큰당 계산량이 그대로 커진다 대규모에서는 원가 경쟁이 안되고 2026 대형 오픈웨이트 모델이 전부 MoE로 틀었다.
그리고 kv캐시를 4분의 1로 줄였다 쳐도 길이에 비례하기에 자라는 성질은그대로라 1M으로가면 또 감당이 안된다 4분의 1도 크다고
이 두 한계가 아래의 고민과 기법들을 만들어냈다
- kv 캐시를 더 줄여야함 -> MLA
- 읽는 범위를 줄여야겠다 -> DSA
- 길이 의존성을 없애자 -> 하이브리드
MLA, KV 캐시를 압축 #
대표 모델은 DeepSeek V2/V3/V3.2 와 Kimi K2 계열이다.
**MLA(Multi-head Latent Attetion)**은 k, v를 저차원 벡터로 압축해 저장하고 어텐션을 계산할때 그 벡터에서 다시 펼치는 방식이다.
GQA   헤드 몇 개가 K,V 한 벌을 나눠 쓴다      → 벌 수를 줄임
MLA   K,V를 통째로 작은 벡터로 압축한다        → 벌 하나의 크기를 줄임
GQA가 나눠쓰는 해법이라면 MLA는 저장하는 것 자체를 작게 만드는 것이다.
압축률이 높아 7~14배 절감이 보고되었고 대신 병렬화랑 궁합이 나빠 배포쪽에서 새로운 문제를 만든다.
GQA가 캐시를 4분의 1로 줄였는데 더 줄이려면 kv헤드를 더 줄여야한다. 근데 그러면 품질이 떨어진다
쿼리 32, KV 8   4개가 공유. 품질 유지
쿼리 32, KV 4   8개가 공유. 품질이 흔들리기 시작
쿼리 32, KV 1   MQA와 같아짐. 품질 하락 확정
GQA는 몇 개가 공유하느냐만 조절할 수 있고, 키워버리면 MQA처럼 문제가 생긴다
DeepSeek이 목표한것은 api 단가 경쟁이였고 kv 캐시가 동시 사용자 수를 정하며 동시사용자수가 gpu당 매출을 정하니 캐시를 줄이는게 곧 원가절감이라 이를 ㅈㄴ 깎아내기 시작했다.
차원 축소 #
그렇다면 나눠쓰는 개수가 아닌 kv캐시 자체를 줄여버리는 하나의 크기를 줄이는 시도를 하게 된것이다
32개의 헤드의 k와 v를 나란히 놓고보면 서로 비슷한 성분이 많다. 헤드마다 다른 관점을 본다고해도 완전히 다른 것을 보지는 않으니까 이 중복을 걷어내면 훨신 낮은 차원에 담을 수 있고 헤드수를 그대로두고도 저장량이 줄어든다.
저장 시   K, V  →  [압축 행렬]  →  잠재 벡터 (저차원)
사용 시   잠재 벡터  →  [복원 행렬]  →  각 헤드의 K, V
회의 서류를 원본 대신 요약으로 남기고 필요할때 복원하는 것과 같다 복원 행렬이 학습으로 정해지므로 무엇을 버리고 무엇을 남길지 모델이 스스로 익힌다
위치 정보를 담는 RoPE는 압축과 궁합이 나빠서 분리된 경로를 따로둔다 처음 익힐대는 압축하되 위치 정보는 따로 챙긴다. 정도로 충분하다.
MLA 서빙의 난제 (중복 저장) #
MLA 서빙의 난제가 여기 있다
어텐션을 TP로 나누면 헤드를 gpu에 분배해야하는데 MLA에 잠재 투영은 헤드별로 깔끔하게 안나뉜다.
결국 여러 gpu가 같은 잠재 벡터를 중복 보관하게 되는데, TP=8이면 캐시가 8배 복제되는 상황이고 압축해서 아낀 메모리를 복제로 도로 날린다.
그래서 어텐션 레이어만 DP로 돌리는 방법이 나왔다. GPU 마다 자기가 맡은 요청의 kv만 들고있으면 되는것이다.
어텐션 레이어 (DP=8)
  GPU 0~3 : 요청 그룹 A를 온전히 처리   ← 자기 KV만 보유
  GPU 4~7 : 요청 그룹 B
            그룹끼리 통신 없음

MoE 레이어 (EP=32)
  같은 32장이 이번엔 전문가를 나눠 담당
AMD ROCm팀에 측정에 따르면 동시요청 64~128개 구간에는 kv복제를 감수하고도 TP+EP가 DP+EP보다 처리량이 52퍼 높았다.
원인은 dp의 성질로 gpu마다 독립적으로 요청을 받으니 요청이 적으면 일부 그룹이 논다. TP는 요청 하나를 여러 gpu가 나눠 처리하므로 소배치에서도 전부 일한다.
메모리가 충분하고 지연이 우선이면 TP, 배치를 키워야하면 DP다.
DeepSeek V3 서빙 #
압축된 형태로 저장된 kv를 다루므로 표준 어텐션 커널이 그대로 통하지 않는다.
--attention-backend flashinfer     # SGLang, FlashInfer의 MLA 경로
--enable-flashinfer-mla            # Kimi K2 계열은 명시가 필요한 경우가 있음
vLLM은 config.json에서 어텐션 구조를 읽어 자동으로 MLA 경로로 라우팅한다 별도 플래그가 필요없다.
# vLLM, DeepSeek V3, 8×H200
vllm serve deepseek-ai/DeepSeek-V3 \
  --tensor-parallel-size 8 \
  --dtype fp8 --kv-cache-dtype fp8 \
  --max-model-len 131072 \
  --gpu-memory-utilization 0.92

# 대규모에서는 EP + DP 어텐션
vllm serve deepseek-ai/DeepSeek-V3 \
  -dp 8 --enable-expert-parallel \
  --dtype fp8 --kv-cache-dtype fp8
Blackwell(B200)이라면 --kv-cache-dtype nvfp4로 양자화해 fp8대비 추가 50퍼 절감까지 가능하고 hopper에서는 하드웨어 지원없이 fp8이 상한
여전히 남아있는 문제점 #
병렬화 선택이 동시성에 따라 뒤집히므로 트래픽 패턴이 바뀌면 이를 재검토해야한다
더 큰 한계는 7~14배로 줄였어도 컨텍스트가 길어지면 그만큼 자란다. 1M 컨텍스트에서는 아직도 부족한 것이다.
DSA, 볼 토큰을 골라냄 #
대표 모델은 DeepSeek V3.2, GLM-5.1/5.2 DeepSeekV4다.
DSA(DeepSeek Spare Attention)는 저장이 아니라 읽기를 줄이는 방식이다.
어텐션을 계산하기 전에 가벼운 필터로 관련있는 토큰을 k개 골라내고 그것만 정밀하게 계산한다.
일반 어텐션: 100만 토큰 전부와 비교해 계산량이 길이의 제곱이다.
DSA: 필터로 2,048개만 고른 뒤 비교해 계산량이 k에 고정
컨텍스트가 10만이든 100만이든 실제 보는것은 고정된 k개라서 길이가 늘어도 어텐션 비용이 거의 그대로다 1M 컨텍스트 모델들이 이 방식을 쓰는 이유다.
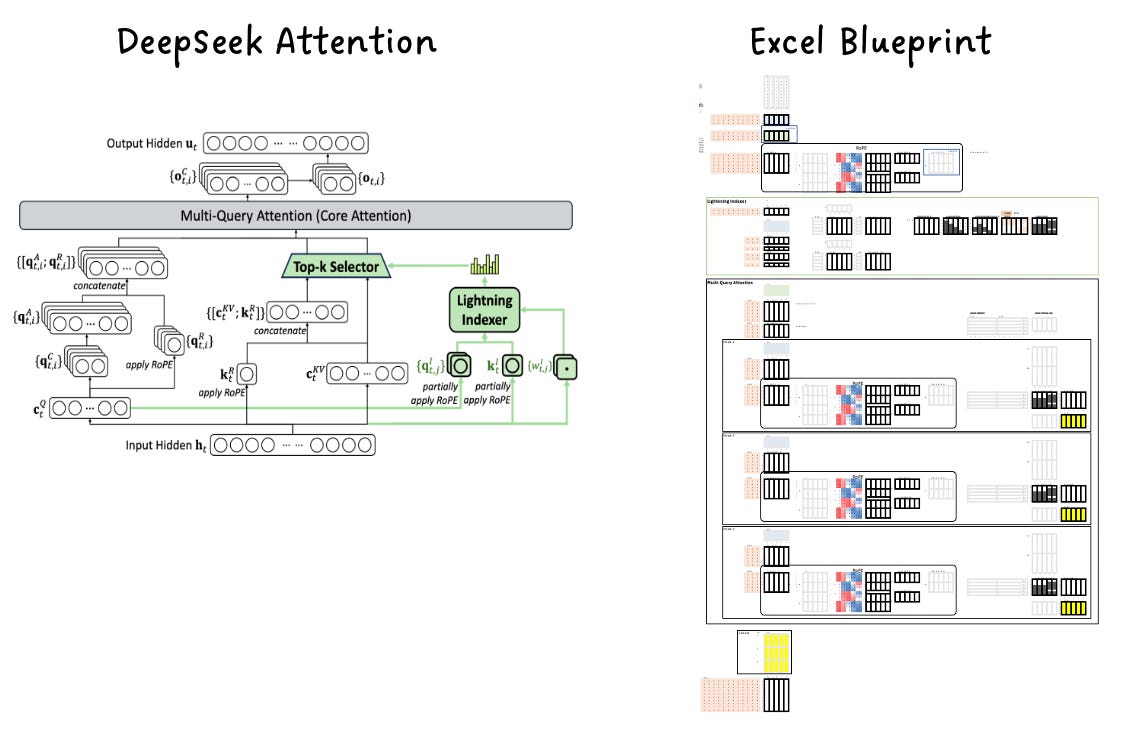
MLA가 저장량을 크게 줄였지만 두 가지 문제점이 남아있었는데
메모리가 여전히 길이에 비례한다는 점이고 압축된것도 100만개면 크다는 것이다.
그리고 계산량이 제곱으로 늘어 토큰이 N개면 Q-K 쌍이 N^2이 된다는 것인데 저장을 줄여도 이 계산은 그대로다.
컨텍스트 길이     어텐션 계산량
─────────────────────────────
    1,000        100만 회
   10,000        1억 회
1,000,000        1조 회
어떤 토큰을 버릴것인가? #
N개만 보는 슬라이딩 윈도우라는 기법이 있다 계산량이 선형이 되지만 멀리 있는 중요한 정보를 놓친다는 특징이있다. 100만 토큰 문서의 앞부분 조항을 참조하여 하는 작업 이런거는 실패한다.
일정 간격으로 샘플링하거나 블록 단위로 나누는 고정패턴도 있는데 계산은 줄지만, 어떤 토큰이 중요한지는 내용에 따라 다른데 고정 패턴은 그걸 반영하지 못한다
세 번째는 내용을 보고 고르는 것, 정확하지만 판단 자체가 비싸지면 의미가 없어진다 어텐션을 아끼려다 필터 계산에서 그만큼 쓰면 의미가 없으니
필터를 극단적으로 경량 #
DSA는 세번째 내용을 보고 고르는 방식이되 필터를 아주 싸게 만들었다. 이게 바로 라이트닝 인덱서
[100만 토큰의 KV]
       ↓
[라이트닝 인덱서]      저차원 투영으로 관련도 점수만 계산
       ↓
[상위 2,048개 선택]    GLM-5.2 기준
       ↓
[정밀 어텐션]         여기만 비쌈
도서관에서 논문을 쓸때 100만권을 다 읽지않고 사서에게 맞는 책 2천권만 뽑아달라하고 그것만 정독하는것
인덱서는 정밀한 어텐션과 달리 대략적인 순위만 매기면 되므로 훨씬 싸다 인덱서 키는 각 kv항목마다 한번 계산해 gpu메모리에 보관하고 매번 다시 만들지 않는다.
상위 k가 고정이라 컨텍스트가 길어도 어텐션 비용이 거의 느맂않고 부수효과로 무관한 정보도 골라내져 노이즈에도 강해진다
여기까지가 DSA가 해결한 부분이다. 제곱으로 늘던 어텐션과 무관해졌고 128K 정도까지는 이걸로 충분하다.
실제로 DeepSeek V3.2가 이 구성으로 나왔다.
다만 모델 전체의 비용이 길이와 무관해진 것은 아니다 어텐션 앞에 인덱서라는 단계가 새로 생겼고, 그 비용은 아직 따져보지 않았다. 128K에서는 어텐션 절감분에 묻혀 보이지 않다가 1M으로 가면 문제가 생기는데
인덱서가 병목이 되는 경우와 IndexShare #
인덱서가 상위 2,048개를 고르려면 후보를 전부 훑어야하는데, 100만개중에서 고르는 일이니 100만개 전부에 점수를 매기게 된다.
어텐션    상위 2,048개하고만 계산      길이와 무관하게 고정
인덱서    100만 개 전부에 점수를 매김   길이에 비례해 증가
어텐션은 고정되어있지만 인덱서는 여전히 길이를 따라다닌다. 128K에서는 이값이 작아서 어텐션에서 아낀것에 비하면 셈 쳐도 되지만 100만이 되면 8배가 되게 된다.
여기서 레이어 수가 곱해지는데 점수 계산 하나는 저차원 투영이라 어텐션 계산보다 훨신 싸지만 61개 레이어면 토큰 하나를 만들때마다 6,100만번을 하게 되는것이다. 개당 비용이 작아도 이정도면 어텐션보다 커진다.
인덱서를 없앨수는 없고 뭘 골라야할지 알아야 어텐션을 건너뛸수있으니까.. 남은 길은 호출 횟수를 줄이는 것 뿐이다.
인접한 레이어들이 고르는 토큰이 크게 다르지 않다. 라는 특징이 여기서 관찰되었는데, 5번 레이어가 중요하다고 판단한 토큰은 6번레이어에서도 중요하다 대체로, 레이어가 깊어지면서 관점이 서서히 바뀌긴하지만 한칸 사이에는 뒤집히지 않는다.
그렇다면 매 레이어가 따로 고를 필요없이 몇개 레이어가 인덱서 하나를 나눠쓰면? ㅋㅋ 다 나눠써 , GLM-5.2가 이 방식을쓰고 IndexShare라고 부른다.
기본 DSA      레이어 1: 인덱서 → 상위 2,048개 선택 → 어텐션
              레이어 2: 인덱서 → 상위 2,048개 선택 → 어텐션
              레이어 3: 인덱서 → 상위 2,048개 선택 → 어텐션
              레이어 4: 인덱서 → 상위 2,048개 선택 → 어텐션

IndexShare    레이어 1: 인덱서 → 상위 2,048개 선택 → 어텐션
              레이어 2:                    ↓ 재사용 → 어텐션
              레이어 3:                    ↓ 재사용 → 어텐션
              레이어 4:                    ↓ 재사용 → 어텐션

→ 인덱서 호출이 1/4로. 1M 컨텍스트에서 토큰당 FLOPs 2.9배 감소
같은 발상이 투기적 디코딩에서도 적용되는데, 드래프트 모델이 토큰 다섯개를 미리 제안할때 그 다섯스템이 각자 인덱서를 돌리면 비용이 다섯배가 된다. SGLang은 첫 스텝에 고른 상위 k를 나머지 네 스텝이 그대로 쓰게 했다. 다섯 토큰이 참조할 과거는 어차피 거의 같으니까
두 최적화를 합쳐 GLM-5.1 대비 단일 사용자 상호작용성이나 1.3~1.4배 개선되었다고 보면 된다.
DeepSeek V4 #
딥시크 v4는 MLA를 버리고 새로 설계했다. 여러 기법들을 섞은 것인데
c4a 어텐션        압축 비율이 다른 경로
c128a 어텐션      또 다른 압축 비율
슬라이딩 윈도우    크기 128. 압축되지 않은 토큰에 대한 지역 정보
K와 V 공유        메모리 2배 절감
DSA              여전히 사용
슬라이딩 윈도우를 둔 이유가 설계의 요점으로 압축은 정보를 잃는데 쿼리 토큰이 압축 경계에 도달하기전에 가까운 토큰만큼은 원본으로 볼수있게하면 지역정보 손실을 막을 수 있다.
1M 컨텍스트, 시퀀스 하나당 KV 캐시 (bf16 기준)
  DeepSeek V3.2 스타일 61레이어 추정치   83.9 GiB
  DeepSeek V4                            9.62 GiB
                                         ↑ 8.7배 작음

실제 배포에서는 인덱서 fp4 + 어텐션 fp8을 써서
bf16 추정치 대비 다시 약 2배 절감
레이어를 균질하게 다룰 수 없다 #
여기서부터 배포 이야기인데
DSA 모델은 레이어들이 두 개 이상의 kv 캐시 그룹으로 나뉘고 그룹마다 블록 기하 구조가 다르다.
페이지드 메모리 관리자가 그룹별로 따로 관리를 해야한다.
이것이 계층 캐시 호환성에 직접 영향을 준다. LMCache 문서에 GLM5.2가 다중 kv캐시 그룹 서로다른 블록 기하로 표시되어있고 SGLang조합은 검증되지 않은 상태로 남아있다..
정밀도를 사용자가 지정하면 안됨 #
레이어마다 최적 정밀도가 다르다.
DeepSeek V4
  프리필   bfloat16 KV 캐시
  디코드   부분적으로 토큰 단위 fp8
  인덱서   fp4
  어텐션   fp8
SGLang은 DSA 모델에 대해서 kv 캐시 dtype을 자동으로 선택한다.
Blackwell (B200/GB300/B300)  → fp8_e4m3, DSA를 TensorRT-LLM 백엔드로 라우팅
Hopper (H200)                → bf16
--kv-cache-dtype 플래그가 필요 없고 하나로 강제하면 이 최적화가 깨진다.
어텐션 백엔드도 마찬가지
GLM-5.2는 glm_moe_dsa 아키텍처
  프리필  → flashmla_sparse
  디코드  → fa3
  인덱서  → sgl-kernel indexer topk
수동 지정은 오히려 최적 경로를 벗어나게 만든다.
하드웨어가 안 맞으면 실행이 안됨 #
이 계열의 가장 실무적인 제약이다.
DSA 커널이 요구하는 것
  라이트닝 인덱서 GEMM
  top-k + 페이지 매핑
  MLA 희소 디코드

  → sm_90 (Hopper) 또는 sm_100 (데이터센터 Blackwell) 전용
  → Ada (sm_89, RTX 4090)에는 폴백 경로 없음
스톡 vLLM/SGLang 스택이 Ada에서 하드 크래시하다 커뮤니티가 Triton, tileang으로 포팅한 사례가 있긴하지만 공식 경로는 아니다
컨슈머 Blackwell(sm_120, RTX 5090)도 데이터센터 Blackwell(sm_100)과 프로그래밍 모델이 달라 같은 커널이 안돈다.
GLM-5.2를 띄우는 명령 #
# SGLang, GLM-5.2 NVFP4, 8×B300
python3 -m sglang.launch_server \
  --model nvidia/GLM-5.2-NVFP4 \
  --tensor-parallel-size 8 \
  --quantization modelopt_fp4 \
  --tool-call-parser glm47 \
  --reasoning-parser glm45 \
  --trust-remote-code \
  --chunked-prefill-size 16384 \
  --mem-fraction-static 0.80
--kv-cache-dtype, --attention-backend 라는 플래그가 빠져있다. 이는 엔진이 자동선택을 하도록 의도한것이다.
있는 것 중에서 놓치기 쉬운것은 파서 설정인데 --tool-call-parser glm47, --reasoning-parser-glm45 는 모델 계열마다 이름이 다르고, 빠뜨리면 도구 호출이 인식되지 않고 사고 토큰이 응답에 섞여 나오게 된다.
MoE 부분은 별도로 켜야한다.
--enable-moe-ep            # SGLang
--enable-expert-parallel   # vLLM
1M 컨텍스트에서는 FP8 KV 캐시가 사실상 필수다 8xH200 기준으로 여유가 거의 없다
하드웨어와 복잡도라는 대가 #
하드웨어 선택지는 좁다 sm_90 이상이 필요하고 워크스테이션 Blackwell도 제외된다.
관리 복잡도도 높은데 vLLM 팀이 밝힌 V4 구현 과제가 그대로 이 복잡도를 보여준다.
이종 어텐션 타입이섞여 kv캐시관리가 복잡하고, 프리필과 디코드가 다른 정밀도를 쓰며 커널 융합과 분리 서빙과 조합이 필욯다ㅏ.
인덱서가 놓칠 위험도 있는데 지금과 무관해 보이지만 여러 단계 뒤에 결정적이 될 정보를 잘라낼 수 있고 초고난이도 다단계추론에서 미세한 손해가 관찰된다.
하이브리드 선형 어텐션, KV를 없애다 #
대표 모델은 Qwen3-Next, Qwen3.5/3.6 시리즈, Kimi Linear, Kimi K3등이 있다.
선형 어텐션은 과거 토큰을 하나씩 저장하는 대신, 고정 크기의 상태 하나를 요약해서 들고 다닌다.
저장할것이 늘지 않으니 kv캐시가 아예 없어진다.
대신 요약본만으로는 특정 문장을 정확하게 꺼내오지 못한다. 그래서 레이어의 4분의 3만 이 방식으로 하고 나머지 4분의 1은 보통 어텐션으로 남긴다.
압축과 선택으로는 길이 의존성이 남는 문제 #
3장의 MLA는 저장량을 7~14배 줄였지만, 여전히 길이에 비례한다. 4장에 DSA는 읽는 범위를 고정했지만 저장은 여전히 전부 한다. 인덱서가 고를 후보가 있어야하니까
MLA   저장 = O(n) × 압축률
DSA   저장 = O(n),  읽기 = O(k)
컨텍스트가 100만이라면 저장이 여전히 100만개분이다.
근본적인 원인은 어텐션 구조에 있는데, 어텐션은 과거 토큰 하나하나를 개별적으로 참조하는 방식이고 개별 참조를 하려면 개별 저장이 필요하다 이 성질을 유지하는한 길이 의존성은 사라지지 않는다.
순환으로 돌아가되 개선 #
RNN은 고정 크기 은닉 상태에 과거를 요약한다. 길이 의존성이 없지만 RNN은 트랜스포머에서 밀려난 이유가 상태가 순차적으로 갱신되어 병렬학습이 안되고 긴 시퀀스에서 앞 부분의 정보가 뭉개지기 때문이다.
Mamba 계열의 DeltaNet 계열 연구는 고정 상태를 유지하되 갱신 규칙을 개선하고 학습 시 병렬 처리가 가능하게 만드는 방향으로 갔다.
Gated DeltaNet은 네 가지를 결합한다.
델타 규칙        기존 기억과 새 정보의 차이만 갱신 (오류 정정형)
지수 게이팅      무엇을 얼마나 잊을지 조절 (상태 포화 방지)
인과적 Conv1D   바로 앞 몇 토큰의 지역 문맥 포착
Q/K L2 정규화   소프트맥스 대신. 값의 폭주 방지
델타 규칙이 핵심인데 순진한 선형 어텐션은 새 정보를 그냥 더하기만 해서 상태가 금세 뭉게진다.
델타 규칙은 이미 기억하고있는 것과 얼마나 다른가를 계산해 그 차이만 반영하므로 기억이 덮어써지지 않고 정정된다.
상태의 크기는 이렇다.
S ∈ R^(d × d),  d = 128
→ 시퀀스가 아무리 길어져도 이 크기는 그대로
→ 레이어당 메모리가 O(n)에서 O(1)로
회의록 전부 보관하고 매번 처음부터 훑는것이 어텐션이라면 선형 어텐션은 한 장짜리 요약본을 계속 갱신하는 것이다
요약본의 한계 #
문제가 하나 남는데 요약본만 들고다니면 300페이지 24번째줄 같은 정확한 문구를 못꺼낸다
정밀 검색 능력이 떨어지는 것이라 그래서 대부분의 레이어를 값싼 선형 어텐션으로 하고 일부는 전체 어텐션으로 남긴다.
Qwen3-Next 80B-A3B, 48 레이어
  [GDN][GDN][GDN][Full Attention] × 12회
   └─ 36 레이어 (75%) ─┘  └ 12 레이어 (25%) ┘
       KV 캐시 없음          KV 캐시 있음
Qwen3.5-397B-A17B는 60레이어에서 같은 4레이어 그룹을 15회 반복하고 Kimi Linear는 KDA 20레이어와 게이트 MLA 7레이어로 대략 같은 비율이다
두 종류의 상태를 함께 관리 #
하이브리드 모델은 레이어에 따라 저장하는 것이 다른데
전체 어텐션 레이어  페이지드 KV 캐시
                   토큰이 늘 때마다 K, V가 쌓임. 길이에 비례해 자람

선형 어텐션 레이어  순환 상태
                   합성곱 상태 + 요약 행렬. 시퀀스당 한 벌. 크기 고정
선형 레이어가 들고 있는 것이 두가지로 하나는 합성곱 상태로 바로 앞 몇 토큰을 담는 작은 버퍼, Conv1D가 지역 문맥을 보려는 창이고 커널 크기만큼 있으면 된다. 다른 하나는 요약 행렬로 128x128짜리 상태다 토큰이 들어올대마다 갱신되지만 크기는 절대 변하지 않는다.
서빙 엔진은 gpu메모리를 고정 크기 페이지로 잘라서 관리하기에 요청이 들어오면 페이지를 빌려주고 끝나면 회수해서 다음 요청에 재사용된다 페이지 크기 하나로 통일되어 있어야 이 회전이 단순해진다. 크기가 제각각이면 회수한 자리에 다음 요청이 안 들어맞아 구멍이 생긴다.
문제는 두 종류의 상태가 요구하는 크기가 다르다는 것이다 숫자를 넣어보면 이렇다.
전체 어텐션 레이어   토큰당 KV 2 KB
선형 어텐션 레이어   시퀀스당 상태 128 KB (길이와 무관)

페이지를 16토큰 단위로 잡으면
  어텐션 한 블록 = 16 × 2 KB = 32 KB
  선형 상태      =            128 KB   → 페이지 4장이 필요

페이지를 선형 상태에 맞춰 128 KB로 잡으면
  선형 상태      = 정확히 한 장
  어텐션 한 블록 = 32 KB만 쓰고 96 KB를 놀림  → 75% 낭비
어느쪽에 맞춰도 손해로 작게 잡으면 선형 상태 하나에 페이지 여러장에 걸쳐 관리해야하고 크게 잡으면 어텐션 블록 페이지에 파편화가 생긴다
vLLM이 푼 방식 #
이 페이지 크기를 고정해두고 거기에 상태를 맞추는 대신 어텐션 블록의 토큰 수를 조절해서 두 상태의 크기를 같게 만든다.
페이지의 물리적 크기는 미리 정해진 값이 아니다 블록 하나에 몇 토큰을 몇 개 담을지를 정하면 거기서 페이지 크기가 나온다
레이어 하나 기준, 토큰당 KV가 2 KB일 때

블록 =  16토큰  →  페이지 =  16 × 2 KB =  32 KB
블록 =  32토큰  →  페이지 =  32 × 2 KB =  64 KB
블록 =  64토큰  →  페이지 =  64 × 2 KB = 128 KB
                              ↑ 토큰 수를 바꾸면 페이지 크기가 바뀜
블록 하나가 곧 페이지 한 장이고 64토큰짜리 블록이라고 페이지를 여러장 쓰는것이 아니라 페이지 한 장이 128KB로 켜지는 것이다
그러면 선형 상태에 맞는 블록 크기를 역산할 수 있다.
선형 상태가 128 KB이고 어텐션이 토큰당 2 KB일 때
  128 KB ÷ 2 KB = 64토큰

블록을 64토큰으로 잡으면
  어텐션 레이어  페이지 한 장 = 128 KB   (토큰 64개분의 KV)
  선형 레이어    페이지 한 장 = 128 KB   (상태 한 벌)
                 ↑ 담긴 내용은 다르지만 크기가 같음
이제 둘 다 페이지 한 장이다. 할당하는 쪽에서는 무엇이 담겼는지 구분할 필요가 없고 회수와 재사용도 한 종류만 다루면 된다.
블록의 토큰수는 모델마다 달라진다 레이어 구성과 헤드수가 다르면 토큰당 kv도 달라지고 선형 상태 크기도 달라지기 때문이다 그래서 사용자가 지정하는 값이 아니라 엔진이 모델 설정을 읽고 계산한다.
즉 파편화를 없애 이제 낭비된 gpu 메모리가 없이 효율적으로 사용할 수 있다. 메모리 한계에 닿아 그 낭비만큼 동시 요청수가 줄어드는데 그 비효율이 없어진것.
LMCache, GPU밖에 kv를 보관하는 계층 #
LMCache라는 개념이 여기서 나오는데 vLLM에 붙는 KV 캐시 저장 계층으로 gpu에서 밀려난 kv를 cpu메모리나 로컬디스크, 원격저장소에 보관했다가 필요할때 다시 가져온다
엔진을 재시작해도 캐시가 남고 여러 vLLM 인스턴스가 하나의 캐시 풀을 공유할 수도 있다.
GPU HBM      뜨거운 KV. 지금 생성 중인 요청들
  ↓ 밀려남
CPU 메모리    최근에 끝났지만 다시 올 수 있는 요청
  ↓
디스크·원격   오래된 것. 여러 인스턴스가 공유 가능
접두사 캐싱이 완전하지 않은 문제 #
접두사 캐싱이 성립하는 근거는 KV의 인과성이다 어떤 토큰의 K와 V는 그 앞 토큰들에만 의존하고 뒤에 무엇이 오든 변하지 않는다.
요청 A: [시스템 프롬프트 2,000][질문 1]
요청 B: [시스템 프롬프트 2,000][질문 2]
         └─ 이 부분의 KV는 두 요청에서 완전히 동일 ─┘
그래서 한 번 계산해 저장했다가 그대로 꺼내 쓰면 된다. 블록 해시가 같으면 내용도 비트 단위로 같다는 것이 보장되기에 표준 어텐션에서는 접두사 캐싱이 쉽다
선형 어텐션에서 문제 #
원리 자체는 같다. 토큰 N개를 처리한 뒤의 상태는 그 N개에만 의존하므로 저장했다가 복원하면 된다.
걸리는것이 캐시 계층쪽인데 KV캐시는 토큰 몇 개당 블록 하나 라는 구조가 있어서 캐싱 계층이 그 구조를 알고 부분 재사용이나 블록 단위 전송을 한다.
순환 상태에서는 그런 구조가 없다. 128x128행렬 하나가 통째로 있을 뿐이고 앞의 절반이라는 것이 존재하지 않는다.
LMCache는 이걸 우회한다. 상태를 등록할때 내용을 모르는 바이트 덩어리로 선언한다 그러면 기존 kv 전송, 저장 경로를 그대로 탈 수 있고 모델마다 전송 코드를 따로짤 필요가 없다.
그러나 이 구조여도 여전히 남아있는 문제는
부분 재사용 불가      앞의 절반만 쓴다는 개념이 없음
내용 기반 처리 불가    압축이나 블렌딩 같은 최적화가 적용 안 됨
엔진 간 공유 불가      바이트 배치가 어텐션 백엔드와 블록 크기에 따라 달라짐
마지막 엔진간 공유 불가가 좀 걸리는데 엔진이 업그레이드되면서 쌓아둔 캐시를 이어 쓰려다가 실패하는 경우가 생긴다.
비트 단위로 같지 않는 문제 #
더 미묘한 제약도 있다 캐시에서 복원한 상태와 새로 계산한 상태가 완전히 같지않다
원인은 부동소수점 덧셈 순서로 같은 값들을 더해도 어떤 순서로 더하느냐에 따라 마지막 자리가 미세하게 달라진다
GDN의 상태 갱신은 순차 누적인데, 실제 커널은 이걸 청크로 쪼개 병렬처리한다. 배치에서 어떤 요청들이 함께 들어있느냐에 따라 쪼개는 방식이 달라지고 누적 순서도 달라진다
배치 구성과 무관하게 같은 결과를 보장하는 실행 모드를 batch-invariant라고 하는데 GDN 백엔드는 이걸 지원하지 않는다.
캐시 사용     상태를 복원해서 이어감
캐시 미사용   처음부터 다시 계산

두 결과가 소수점 아래에서 미세하게 다름
→ 다음 토큰의 확률 분포가 아주 조금 달라짐
→ 경계에 걸린 토큰에서 선택이 갈릴 수 있음
품질 수준에서는 차이가 없고 점수를 재면 같게 나온다 다만 토큰 단위로 같은 출력을 보장하지는 못한다
평가 파이프라인이나 회귀 테스트처럼 재현성이 필요한 작업에서는 캐시를 끄고 재야한다. 어제 돌린 결과와 오늘 결과가 다를 때 모델이 바뀐건지 캐시 때문인제 구분이 안되기 때문이다
참고로 vLLM의 Mamba 계열 접두사 캐싱 정렬 모드는 아직 실험 단계다
블록 크기 하나가 다른 설정을 연쇄적으로 정함 #
앞에서 엔진이 계산한 블록 토큰 수 N이 여기서 나온다. 캐싱과 계층이 배칭 설정이 전부 이 값에 맞춰져야한다.
N = 페이지 하나에 담기는 토큰 수 (엔진이 모델 설정에서 계산)
  ↓
LMCache의 --chunk-size       저장하고 전송하는 단위
vLLM의 --max-num-batched-tokens   한 번에 처리하는 토큰 수
이 값이 어긋나면 부분 페이지가 생기고 N이 64인데 청크가 100토큰이면 첫 페이지는 꽉 차고 두번째페이지는 36토큰만 담기는 문제가 생긴다 덜 찬페이지는 캐싱 대상이 아니라 그만큼 재사용 기회를 잃는다
그래서 이계열을 배포할때는 N부터 확인하고 나머지를 그 배수로 맞추는 순서가 필요하고 모델이 바뀌면 N이 바뀌기에 세 값을 다시 잡ㅇ야한다.
Qwen3.5 Serving #
이 계열의 모델들은 대개 다중 토큰 예측 헤드를 갖고 나온다.
투기적 디코딩의 드래프터를 그대로 재활용되고 동시성이 낮을때만 이득이라는 원칙은 그대로다.
--speculative-config '{"method":"qwen3_next_mtp","num_speculative_tokens":1}'
vllm serve Qwen/Qwen3.5-397B-A17B-FP8 \
  -dp 8 --enable-expert-parallel \
  --language-model-only \
  --reasoning-parser qwen3 \
  --enable-prefix-caching
--language-model-only는 이 계열이 멀티모달을 내장한 경우가 많아서 필요하다.
텍스트만 쓸거면 비전 인코더를 로드하지 않아 메모리 초기화 시간을 아낀다
어텐션 백엔드는 지정하지 않았다 엔진이 하이브리드 kv 캐시 관리자를 자동으로 쓰게한다.
선형 어텐션으로 KV를 없앴기에 정밀검색과 재현성을 내준 TradeOff #
정밀 검색에서는 이론적 약점이 있는데 전체 어텐션을 25%로 보완하지만 완전하지는 않다. 아주 긴 문서에서 특정 세부를 정확히 인용해야 하는 작업이라면 순수 어텐션과 모델과 비교 측정할 가치가 있다.
엔진 지원도 늦는다 vLLM은 Qwen3-Next지원을 위해 Flash Linear Attention의 Triton 커널을 통합하고 하이브리드 kv 캐시 관리자를 새로 도입해야만 했다. 돌아간다와 최적화되었다 사이에 몇 주에서 몇달의 간격이 있다.
그리고 캐싱의 결정성이 없다는 점은 평가 파이프라인을 짤 때 고려해야한다.
MoE와 전문가 병렬 #
MoE, 어텐션 #
MoE는 FFN쪽 이야기라 어텐션 방식과 독립적으로 조합된다
어텐션 축                    ×    FFN 축
──────────────────────────       ──────────
GQA / MLA / DSA / 하이브리드        dense / MoE

실제 조합
  GQA + dense       Qwen3.6-27B
  GQA + MoE         Qwen3 MoE 계열
  MLA + MoE         DeepSeek V3, Kimi K2
  DSA + MoE         GLM-5.2, DeepSeek V4
  하이브리드 + MoE   Qwen3.5/3.6, Kimi K3
복습
GQA: Grouped Query Attention, LLM의 추론 속도를 높이기위해 Query를여러 그룹으로 묶고 하나의 그룹이 KV헤드 하나를 공유하도록 하여 메모리 사용량을 줄이는 기술MLA: Multi-head Latent Attention, DeepSeek-V3 등에 사용된 기술로 kv캐시를 저차원 벡터로 압축하여 메모리 용량을 획기적으로 줄이면서도 연산 정확도는 성능 저하 없이 유지하는 기술
DSA: Dense Sparse Attetnion LLM이 긴 문맥을 처리할 대 발생하는 계산량과 메모리 비용을 줄이기 위해 개발된 긴 문맥에서 과거 토큰을 다 계산하지 않고 가벼운 인덱서로 중요한 상위 토큰만 골라내어 그 페이지만 정밀 연산해 효율과 속도르 극대화하는 희소 어텐션 기법이다.
일반 모델은 토큰마다 FFN 가중치를 전부쓴다 MoE는 전문가라 부르는 FFN 모듈을 수백 개 두고 토큰마다 몇개만 골라서 쓴다
        [토큰]
           ↓
       [라우터]      점수 계산 → 상위 8개 선택
           ↓
   ┌──┬──┬──┬──┬─ ... ─┬──┐   전문가 256개
   │  │██│  │██│       │  │   (██ = 이번에 켜진 것)
   └──┴──┴──┴──┴───────┴──┘
           ↓
       [결과 합산]
DeepSeek-V4-Flash는 전문가 256개 중에 8개를 쓰고 284B 중 13B만 계산에 참여한다 종합병원 전문의 256명이 있어도 환자 한명당 담당 8명만 부르는 것과 같다
문제 - TP로 나누면 MoE 존재 이유가 사라짐 #
전문가 256개를 32GPU에 어떻게 나눌지가 문제다 TP방식을 그대로 쓰면 전문가 하나하나의 가중치가 32장으로 잘려 32장에 분산된다
토큰이 전문가 8개를 선택해도 그 8개의 조각이 32장에 흩어져있으니 32장 전부가 계산에 동원된다 실제로쓰는것은 256개중에 8개, 3% 뿐인데 말이다.
일부만 켜서 계산을 아끼자는 설계가 무효화된다. 메모리도 낭비된다 전문가 가중치가 모든 gpu에 조각내어 복제되면 kv캐시에 쓸 공간이 그만큼 줄어든다
해법 - 전문가를 통째로 배정 EP #
TP — 세로로 자름
        GPU0      GPU1      GPU2      GPU3
전문가0  [1/4]    [1/4]    [1/4]    [1/4]
전문가1  [1/4]    [1/4]    [1/4]    [1/4]
전문가2  [1/4]    [1/4]    [1/4]    [1/4]
전문가3  [1/4]    [1/4]    [1/4]    [1/4]

EP — 가로로 자름
        GPU0      GPU1      GPU2      GPU3
전문가0  [전체]
전문가1            [전체]
전문가2                      [전체]
전문가3                                [전체]
저장량은 같다 4개의 행렬을 4장에 나눴으니 장당 1개분으로다른것은 모양이다
EP는 전문가를 통째로 gpu에 배정하고 토큰당 담당 gpu로 보냈다가 결과를 되받는다.
EP=32, 전문가 256개
  GPU0: 전문가 0~7 담당    GPU31: 전문가 248~255 담당

토큰이 전문가 8개 선택
  ↓ all-to-all — 각 토큰을 담당 GPU로 전송
  ↓ 각 GPU가 자기 전문가로 계산
  ↓ all-to-all — 결과를 원래 자리로 회수
gpu끼리 오가는것이 가중치가 아니라 토큰으로 바뀌어 오버헤드가 줄어든다
              TP=32                    EP=32
전문가 배치    조각내서 전 GPU에         통째로 한 GPU에
동원되는 GPU   항상 32장                 선택된 8개를 가진 곳만
오가는 것      계산 결과 (all-reduce)    토큰 (all-to-all)
GPU당 가중치   256개 전부의 1/32         8개 전체
크기 비교 (히든 차원 7,168, 전문가 중간 차원 2,048, BF16)

토큰 하나의 벡터
  7,168 × 2 바이트 = 14 KB
  ▏

전문가 하나의 가중치
  게이트·업·다운 3개 행렬 × 7,168 × 2,048 × 2 바이트 = 88 MB
  ██████████████████████████████████████████████████
                                          토큰의 약 6,300배
플래그는 이렇다 빠뜨리면 TP방식으로 떨어진다
--enable-expert-parallel   # vLLM
--enable-moe-ep            # SGLang
전문가 부하 편중 (expert load imbalance) #
이론상 모든 전문가가 균등하게 뽑혀야 gpu들이 골고루 일을 하니까 좋은데
특정 전문가 작업들이 너무 인기가 많아 특정 gpu에만 일이 몰리는 현상이 전문가 부하 편중이라고 한다.
EP를 켠 MoE 배포에서 가장 흔한 성능 손실 원인이다.
실측 예시
  전문가 47번  : 평균의 7.2배
  전문가 231번 : 평균의 0.23배

47번을 맡은 GPU만 계속 바쁘고 231번을
47번을 맡은 gpu만 계속 바쁘고 231번을 맡은 gpu는 놀게 된다. MoE 레이어는 모든 gpu가 끝나야 다음 레이어로 넘어가므로 가장 느린 gpu가 전체속도를 결정한다
GPU5  (47번 담당):  ████████████████  ← 이 시간만큼 전원 대기
GPU28 (231번 담당): ██
                      └ 놀고 있음 ┘
EPLB로 이를 해결할 수 있는데 EPLB는 라우팅 통계를 보고 인기 전문가를 여러 gpu에 복제하고 인기 전문가끼리 같은 Gpu에 몰리지 않도록 재계산한다, 은행 창구에 번호를 순서대로 배정했다가 3번 업무 손님이 7배로 많다는 것을 알고 3번 창구를 늘리는 것과 같다.
--enable-eplb --eplb-algorithm deepseek --ep-num-redundant-experts 32
대략 돌려보면 실측에서 편중이 7.2배에서 1.9배로 낮아지고 처리량이 18% 올랐다.
중복 전문가 32개 추가로 가중치 메모리 12.5%(32/256) 늘어나는것이 트레이드 오프다
모델마다 달라지는 두 가지 #
일부 모델은 항상 켜지는 공유 전문가를 둔다. DeepSeek-R1은 공유 전문가 1개를 갖고, 모든 토큰이 쓰므로 배치 전략도 달라진다.
all-to-all 백엔드도 선택지가 있다.
allgather_reducescatter   범용
naive                     기본
deepep_high_throughput    처리량 우선 (프리필에 적합)
deepep_low_latency        지연 우선 (디코드에 적합)
프리필과 디코드에서 유리한 백엔드가 다르다 PD 분리를 하고있다면 각각 다르게 설정할 수 있다.
대가 - 가중치를 던 만큼 통신이 늘어남 #
all to all은 예측이 안되는데 어느 gpu에 토큰이 몇 개 갈지 라우터가 정할때까지 모르므로 버퍼를 미리잡거나 통신을 계산과 겹치기가 어렵다
노드를 넘으면 급격히 나빠지는데 32장이면 992개 통신 경로가 동시에 열리는데 InfiniBand로 나가면 경로가 몰려 실효 대역폭이 떨어진다
배치가 작으면 gpu가 노는데 토큰이 적으면 일부 전문가만 선택되고 나머지 gpu는 할일이 없다
멀티모달이 프리필에 남기는 부담 #
대표 모델은 Qwen3.5/3.6 시리즈와 Kimi K2.5/K2.6
얼리퓨전과 레이트퓨전 #
이미지와 비디오를 텍스트와 함께 처리하는 방식이 둘로 갈린다
레이트 퓨전은 텍스트 모델을 완성한 뒤 비전 인코더를 어댑터로 붙인다 얼리퓨전은 사전학습 단계부터 이미지 토큰과 텍스트 토큰을 함께 학습한다.
문제. 이미지로 인한 프리필 증폭 #
이미지 하나가 수백에서 수천 토큰으로 변환된다
텍스트 프롬프트 500토큰
+ 이미지 3장 × 각 1,500토큰
= 프리필 5,000토큰

→ 텍스트만 있을 때의 10배
프리필 비중이 큰 워크로드가 되므로 최적화 방향도 그쪽을 따라간다
투기적 디코딩은 이득이 작아지고 프리필 자원 배분과 청크 크기가 중요해진다.
배포 - 멀티모달에서 챙길 플래그 #
같은 이미지가 반복 등장하는 워크로드라면 전처리 결과를 재사용할 수 있다. 이미지의 해시를 캐시키로 쓰는 방식으로 접두사 캐싱과 같은 원리고, 문서 QA 처럼 같은 이미지에 여러 질문이 오는 경우 효과가 크다
--mm-processor-cache-type shm
비전 인코더는 언어 모델 본체와 크기와 성격이 달라 같은 병렬화를 강요하면 비효율이다
--mm-encoder-tp-mode data
얼리퓨전 모델은 텍스트만 쓸 때도 비전 부분이 함께 로드되므로 안쓸꺼면 명시적으로 꺼야한다.
--language-model-only
전체 설정은 아래와 같다
vllm serve Qwen/Qwen3.5-397B-A17B-FP8 \
  -dp 8 --enable-expert-parallel \
  --mm-encoder-tp-mode data \
  --mm-processor-cache-type shm \
  --reasoning-parser qwen3 \
  --enable-prefix-caching
이미지 캐싱이 통하는 조건은 정확히 같은 이미지에만 통한다는 것이고 크기나 압축이 조금만 달라도 해시가 달라지므로 적용되지 않는다.
새 모델 진단 절차 #
모델 카드를 열고 여섯 단계를 순차적으로 밟는다 실무에서 반복해 쓰이게 될 부분이다.
1. 계열 판정 #
config.json이나 모델 카드에서 확인
architectures                     계열의 첫 단서
                                  예: glm_moe_dsa, qwen3_next, deepseek_v3
num_hidden_layers                 레이어 수
num_attention_heads               쿼리 헤드
num_key_value_heads               KV 헤드
kv_lora_rank 등 압축 관련 필드      있으면 MLA
인덱서 관련 필드, index_topk        있으면 DSA
layer_types 또는 유사 필드          있으면 하이브리드
num_experts                       있으면 MoE
num_experts_per_tok               토큰당 활성 전문가
shared_expert_intermediate_size   공유 전문가 유무
num_nextn_predict_layers          MTP 헤드 유무
vision 관련 중첩 config            멀티모달
KV 헤드가 명시되어 있고 레이어가 균질     → GQA (2장)
압축 관련 필드가 있음                    → MLA (3장)
인덱서 관련 필드가 있음                  → DSA (4장)
레이어 패턴이나 선형 어텐션 필드가 있음    → 하이브리드 (5장)
2. KV Cache 규모 파악 #
계열에 따라 방법이 다른데
GQA        2 × 레이어 × KV헤드 × 헤드차원 × 바이트
           곱셈 한 번으로 계산 가능

MLA        압축 차원 기준. 모델 카드나 엔진 문서 확인
           표준 공식이 안 통함

DSA        인덱서 캐시 + 어텐션 캐시를 따로
           엔진이 자동 관리하므로 실측이 빠름

하이브리드  전체 어텐션 레이어만 계산 + 선형 레이어 상태
           전체 어텐션이 25%뿐이므로 그만큼만
MLA, DSA는 손으로 계산하기 어렵고 짧은 컨텍스트로 서버를 띄워 token_usage 지표를 보고 역산하는 편이 빠르다
3. 하드웨어 게이팅 확인 #
□ 컴퓨트 능력이 커널 요구사항을 만족하는가
   DSA    sm_90 또는 sm_100 필요. Ada(sm_89) 불가
   NVFP4  Blackwell 필요. Hopper는 FP8까지
□ 데이터센터인가 워크스테이션인가
   sm_100과 sm_120은 프로그래밍 모델이 다름
□ AMD나 Ascend라면 해당 스택이 이 아키텍처를 지원하는가
4. 소프트웨어 버전 확인 #
□ vLLM / SGLang 최소 버전
□ transformers 등 하위 라이브러리 버전
□ 필요한 파서 이름 (tool-call, reasoning)
□ 사용 가능한 체크포인트 형식 (FP8 / NVFP4 / MXFP4)
파서 이름이 모델 계열마다 다르다 GLM5.2는 glm47 glm45, Qwen Coder는 qwen3_coder, Qwen 범용은 qwen3이다.
빠뜨리면 도구 호출이 인식되지 않는데 증상이 모델이 도구를 안쓴다로 나타나 모델 성능 문제로 오인하기 쉽다
5. 엔진에게 맡길 것과 지정할것 #
오픈소스 생태계에서 아키텍처가 복잡해지면서 엔진의 자동선택이 사용자의 수동 설정보다 나은 영역이 늘었다.
엔진에 맡길 것
  DSA 모델의 --kv-cache-dtype       레이어별로 다른 최적값을 자동 선택
  DSA 모델의 --attention-backend     프리필/디코드/인덱서를 각각 다르게
  하이브리드 모델의 블록 크기 조정    두 종류 상태를 맞춰 단편화 방지
  MLA 라우팅                        config.json에서 자동 인식

반드시 지정할 것
  --enable-expert-parallel / --enable-moe-ep    MoE면 필수
  --tool-call-parser, --reasoning-parser        모델별 이름 확인
  --tp-size, --dp-size 등 병렬화 규모
  --quantization                                체크포인트에 맞춰
모르면 지정하지 않는 편이 낫다. 예전에는 수동 튜닝이 이득이었지만 이종 구조 모델에서는 잘못 지정하면 엔진의 최적화를 깨뜨린다
최소 구성으로 띄우고 실측 #
# 짧은 컨텍스트, 보수적 메모리 설정으로 먼저 뜨는지 확인
--max-model-len 8192 --mem-fraction-static 0.7

# 뜨면 지표로 실제 KV 소요를 역산
curl -s localhost:30000/metrics | grep token_usage
계열별 비교 선택 #
네 계열 요약
| 항목 | GQA | MLA | DSA | 하이브리드 |
|---|---|---|---|---|
| 무엇을 줄이나 | 저장 (헤드 공유) | 저장 (차원 압축) | 읽기 (토큰 선택) | 저장 (상태로 대체) |
| KV 캐시 | 표준의 1/4~1/8 | 7~14배 압축 | 압축 + 선택적 읽기 | 25% 레이어만 |
| 길이 의존성 | 있음 | 있음 | 저장은 있음 | 75% 레이어에서 없음 |
| 레이어 균질성 | 균질 | 균질 | 이종 | 이종 |
| 병렬화 | TP | TP 또는 DP 어텐션 | TP + EP | TP + EP |
| 커널 | 표준 | MLA 전용 | DSA 전용, 게이팅 강함 | FLA Triton |
| 접두사 캐싱 | 완전 | 완전 | 그룹별 관리 필요 | 비트 단위 비동일 |
| 하드웨어 제약 | 낮음 | 중간 | 높음 | 중간 |
| 배포 난이도 | 낮음 | 중간 | 높음 | 중간 |
같은 조건 다른 아키텍처 #
동시 요청 100개, 평균 컨텍스트 32k라는 전제조건에서 설정이 갈리는 케이스
Qwen3.6-27B (GQA dense)
  --tp-size 2 --quantization fp8 --kv-cache-dtype fp8_e5m2
  --chunked-prefill-size 4096
  → 단순. 손으로 KV 계산 가능

DeepSeek V3 (MLA + MoE)
  --tensor-parallel-size 8 --enable-expert-parallel
  --dtype fp8 --kv-cache-dtype fp8
  → DP 어텐션은 동시성을 보고 판단

GLM-5.2 (DSA + MoE)
  --tensor-parallel-size 8 --enable-moe-ep
  --tool-call-parser glm47 --reasoning-parser glm45
  --chunked-prefill-size 16384 --mem-fraction-static 0.80
  → KV dtype과 어텐션 백엔드는 지정하지 않음

Qwen3.5-397B (하이브리드 + MoE + 멀티모달)
  -dp 8 --enable-expert-parallel
  --language-model-only --reasoning-parser qwen3
  → 블록 크기는 엔진이 자동 조정
상황별 선택 #
단일 GPU, 개인 사용
  → GQA dense
  배치 1에서는 MoE의 활성 파라미터 이점이 안 나오고
  총 파라미터를 메모리에 올리는 부담만 남음

중규모 서버, 일반 워크로드
  → MLA + MoE
  KV 압축과 전문가 병렬의 조합이 원가에 유리

1M 컨텍스트가 필요
  → DSA 계열
  단, 하드웨어가 sm_90 이상인지 먼저 확인

긴 컨텍스트 + 하드웨어 제약
  → 하이브리드 선형
  DSA보다 하드웨어 요구가 덜함

멀티모달 필요
  → 얼리퓨전 계열 (Qwen3.5 이상, Kimi K2.5 이상)
  프리필 최적화에 자원 집중