NVLink, NVSwitch
LLM을 단일 서버 내 8개의 GPU로 분산 학습할 때, 각 GPU는 매 스텝마다 자신이 계산한 기울기 데이터를 나머지 7개의 GPU와 전부 교환 All-Reduce를 해야한다.
이 막대한 통신 트래픽을 기존 메인보드의 PCIe 버스에 태우면 어떤 물리적 붕괴가 발생하며, 이를 우회하는 전용망은 어떻게 설계되어 있을까?
멀티 GPU 환경에서 성능의 핵심은 단일 GPU의 연산력이 아니라, GPU 간 데이터를 얼마나 빠르게 손실 없이 전송할 수 있느냐에 달린 상호 연결 Interconnect 아키텍처에 있다.
NVLink #
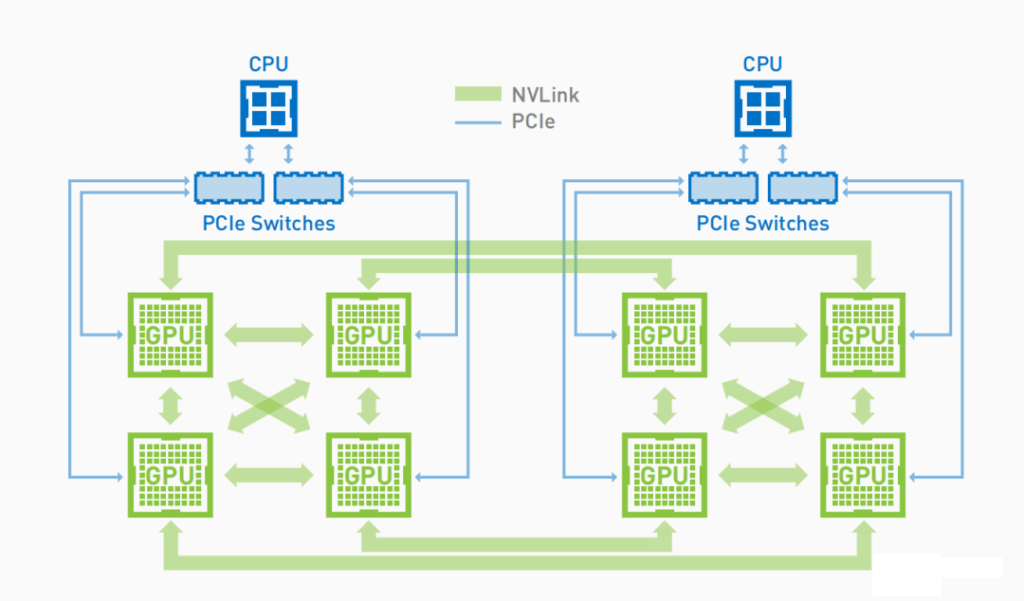
기존 PCIe 버스의 물리적 한계를 우회하기 위해, 메인보드 하단을 거치지 않고 GPU, GPU를 상단 또는 전용 베이스보드(SXM)를 통해 직접 연결하는 고속 P2P 하드웨어 인터커넥트 기술이다.
NVSwitch #
단일 서버 내에 GPU개수가 4, 8개로 늘어날 경우 모든 GPU를 1:1로 직접 연결 Full Mesh 하는 것은 물리적인 Pin 개수의 한계로 불가능하다.
이를 해결하기 위해 서버 내부에 탑재되는 전용 라우팅 ASIC 칩으로 어떤 GPU간의 통신이든 병목 없이 최대 대역폭을 보장하는 완전 비차단 교차장치 구조를 제공한다.
SXM (Server PCI Express Module) 폼팩터 #
일반적인 그래픽카드처럼 메인보드 PCIe 슬롯에 수직으로 꽂는 형태가 아니라. NVSwitch가 내장된 전용 메인보드 위에 GPU를 수평으로 밀착시켜 장착하는 엔터프라이즈 전용 폼팩터다. NVLink 물리적 핀들이 이 보드를 통해 배선된다.
문제 정의 #
PCIe 토폴로지에 의존하여 멀티 GPU 분산 학습을 수행할 때, 데이터 링크 계층에서 발생하는 치명적인 병목 현상이다.
- 대역폭 불균형 Bandwidth Mismatch: GPU 내부의 HBM 대역폭은 초당 1.5~3TB에 달하지만, 이를 외부로 내보내는 PCIe Gen4x16 레인의 최대 양방향 대역폭은 64GB/s 에 불과하다. 연산은 1초만에 끝나는데 데이터를 교환하는데 30초가 걸리는 극단적인 IO병목이 발생한다.
- PCIe 스위치 루트 컴플렉스 (Root Complex) 혼잡: 8대의 GPU가 동시에 데이터를 브로드캐스트할 경우, 모든 트래픽이 메인보드의 PCIe 스위치로 몰려든다. 버스 경합으로 인해 패킷충돌과 큐 대기열이 포화상태가 되며, 지연시간이 기하 급수적으로 폭증한다.
Solution #
NVIDIA는 통신 대역폭을 확장하기 위해 PCIe 버스를 완전히 포기하지 않고 독자적인 하드웨어 통신망을 서버 내부에 구축했다.
- 다중 레인 본딩(Bounding)을 통한 대역폭 극대화: NVLink는 하나의 물리적 선이 아니라 여러 개의 고속 직렬 링크로 구성된다. A100 텐서코어 GPU 기준 1개의 GPU에는 12개의 NVLink가 탑재되어 있으며, 이를 모두 합치면 양방향 600GB/s라는 PCIe 대비 약 10배 넓은 물리적 대역폭을 제공한다.
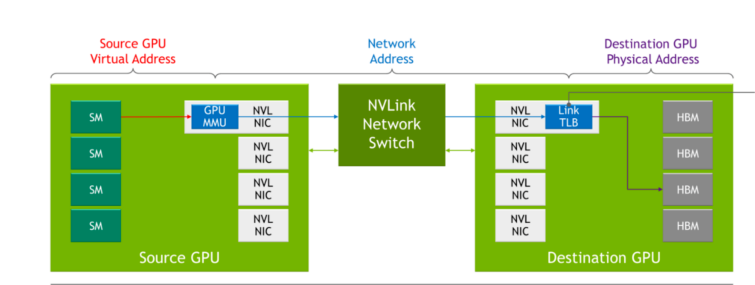
- 통합 메모리 주소 공간 (Unified Memory Architecture): NVLink는 단순히 데이터를 복사해 넘기는 네트워크 케이블이 아니다. 물리적 메모리 컨트롤러 레벨에서 연동되어, 0번 GPU의 스레드가 1번 GPU의 HBM 메모리 주소 (Remote Memory)에 마치 자신의 로컬 메모리인 것처럼 직접 load/store 명령을 내릴 수 있게 해준다.
동작 원리 #
GPU0에서 계산된 텐서 데이터가 GPU7로 전송될때 하드웨어 데이터 패스를 추적해보겠다.
(SXM 및 NVSwitch 환경 기준)
- 공유 메모리에서 NVLink 컨트롤러로: GPU0의 SM(Streaming Multiprocessor) 연산 코어에서 생성된 최종 기울기 데이터가 L2 캐시로 플러시된다. 이후 데이터는 PCIe PHY(물리 계층)가 아닌 GPU 칩 외각에 배치된, 전용 NVLink MAC/PHY 블록으로 전달된다.
- GPU 칩 외부로의 출력 (SXM 베이스보드 진입): 데이터 패킷이 전기적 신호로 변환되어 GPU 칩셋 하단의 초고밀도 핀을 통해 메인보드(SXM 베이스 보드) 기판 내부의 구리 배선으로 쏟아져 들어간다.
- NVSwitch 라우팅 (Crossbar Traversal): 전기 신호는 베이스보드에 납땜되어 있는 NVSwitch ASIC 칩으로 진입한다. NVSwitch는 내부의 논리적인 크로스바 회로를 통해 입력포트 GPU0와 목적지 포트 GPU7를 물리적으로 Circuit Switching 한다. 이 과정에서 다른 GPU간의 통신 GPU1 -> GPU2과 간섭이 전혀 일어나지 않는다.
- 목적지 GPU HBM 안착: 라우팅된 신호는 다시 베이스보드의 배선을 타고 GPU7의 NVLink PHY로 진입하며, 메모리 컨트롤러를 거쳐 GPU7의 HBM 메모리를 직접 기록 Direct Write 된다. 이 모든 과정에서 호스트 CPU의 개입은 0이다.
시스템 로우레벨 메트릭 및 프로파일링 로그 분석 #
엔지니어가 서버에 접속하여 NVLink로 물리적 연결 상태와 대역폭 상태를 확인하는 터미널 명령과 출력 로그다.
root@ai-server:~# nvidia-smi nvlink -s

GPU 0: NVIDIA A100-SXM4-40GB
         Link 0: Data Rx: 23154 MB, Data Tx: 23154 MB
         Link 1: Data Rx: 23153 MB, Data Tx: 23153 MB
         ...
         Link 11: Data Rx: 23154 MB, Data Tx: 23154 MB
GPU 1: NVIDIA A100-SXM4-40GB
         Link 0: Data Rx: 23154 MB, Data Tx: 23154 MB
...
- 단일 GPU에 12개의 물리적 NVLink(Link 0 ~ 11)가 모두 활성화되어 작동중임을 나타낸다.
Data Rx(수신)와Data Tx(송신) 값이 링크별로 균일하게 상승하고 있다면, 하드웨어 토폴로지가 NVSwitch를 통해 완벽한 밸런싱을 이루고 있으며 분산 학습의 통신 트래픽이 NVLink로 정상적으로 흐르고 있음을 증명한다 값이 0이거나 특정 링크만 값이 누락되어 있다면 하드웨어의 결함(케이블 단선 또는 핀 불량)을 의심해야한다.
프로파일링/설정 #
AI 인프라 환경에서 분산 학습 라이브러리 NCCL(NVIDIA Collective Communications Libray)가 하드웨어 통신망으로 NVLink를 선택했는지 확인하고 강제하는 환경 변수 튜닝 기법이다.
NCCL 디버그 로그 활성화 및 통신망 진단: PyTorch DistributedDataParallel(DDP)학습 스크립트를 실행할 때, 하드웨어 라우팅 트리를 소프트웨어 계층에서 분석하기 위해 디버그 레벨을 올린다.
# NCCL 내부의 채널 생성 및 프로토콜 선택 로그 출력
NCCL_DEBUG=INFO python distributed_train.py
터미널에서 확인해ㅑ야할 핵심 로그 라인들은
ai-server:1234:1234 [0] NCCL INFO Channel 00/12 : 0 1 2 3 4 5 6 7
ai-server:1234:1234 [0] NCCL INFO Using internal Network NVLink
이 로그가 Using internal Network PCIe, SHM(Shared Memory)로 출력한다면, NVSwitch 구성이 망가졌거나 도커 컨테이너 실행시 호스트의 IPC(Inter-Process Communication) 및 하드웨어 볼륨 마운트 권한이 부족하여 NVLink 드라이버를 인식하지 못한 치명적인 상태다
PCIe 통신 강제 차단 설정도 할 수 있다.
시스템에 NVLink가 존재함에도 소프트웨어 버그나 설정 문제로 PCIe를 혼용하는것을 원천 차단하려면 다음처럼 하면 된다.
# 피어투피어 통신 시 PCIe(P2P) 경로 사용을 명시적으로 비활성화하고 NVLink만 사용하도록 강제
export NCCL_P2P_DISABLE=0
export NCCL_P2P_LEVEL=NVL