AWS Aurora 2nd
Aurora 정리를 한번 한적이 있었는데, 잊고 있다가 다시 공부할겸 작성

Aurora는 DB Engine이 아니라 로그 기반 분산 스토리지를 가진 클라우드 네이티브 데이터베이스 시스템이다.
RDS랑 가장 큰 차이점은 스토리지 레이어를 완전히 분리,분산,관리형으로 재설계 했다는 점이다.
Compute <-> Storage 분리 #
기존 RDS(MySQL/InnoDB) 디비 인스턴스는 쿼리 처리 + 버퍼풀 + 로그 + 데이터파일 구조고
replica는 binlog 기반의 복제를 지원했으며 장애시 스토리지 + 인스턴스를 동시 복구했다.
그러나 Aurora는 DB 인스턴스는 SQL 파싱 / 옵티마이저 / 실행 / 버퍼 캐시 구조고
Aurora Storage에 Redo Log 단위 분산 스토리지 (완전 별도 시스템)이 존재한다.
즉, compute는 가볍게, storage는 항상 살아있고 자동 복구를 지원한다.
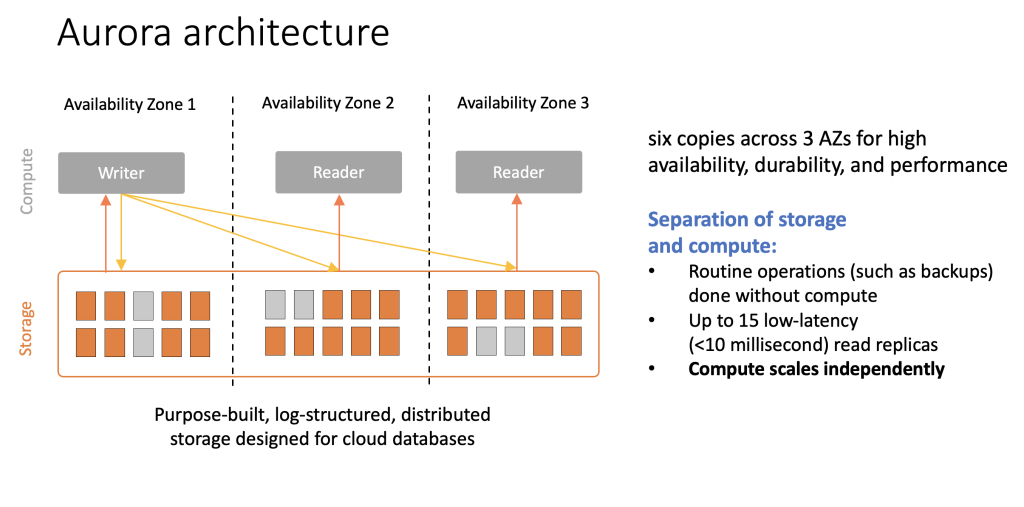
- 6-way reeplication + 3 AZ
- 데이터는 3 AZ x 2 copies = 6 copies
- 인스턴스와 무관하게 항상 유지된다.
- Quorum 기반 쓰기/읽기
- write quorum: 6중 4
- read quorum: 6중 3
- 일부 스토리지는 노드 장애시 즉시 지속이 가능하다.
- Page 쓰기 없음, Log만 씀
- InnoDB
- 더티 페이지 flush
- dobule write buffer
- fsync 비용이 크다.
- Aurora
- Redo Log만 네트워크로 전송
- 페이지 조립은 스토리지 에서 수행함
- 쓰기 경로가 짧고 예측이 가능하다.
- InnoDB
Client
  ↓
Aurora Writer Instance
  - SQL 실행
  - Redo Log 생성
  ↓
Aurora Storage
  - 6-way 분산 기록
  - 4개 ACK 도달 시 commit
중요한점은 Data page flush가 없다는점, Redo Log 단위로만 네트워크 I/O를 한다는 점이고 Commit Latency가 안정적이다.
Aurora Read Path(읽기 흐름) #
버퍼 캐시에 있으면 인스턴스 메모리 없으면 스토리지에서 Redo + Base Page 조합으로 필요한 페이지만 네트워크로 가져온다.
Replica는 스토리지를 직접 읽고 binlog replay가 필요없다. 레플리카 속도가 매우 빠르다. (수 분)
Writer / Reader 구조와 endpoint #
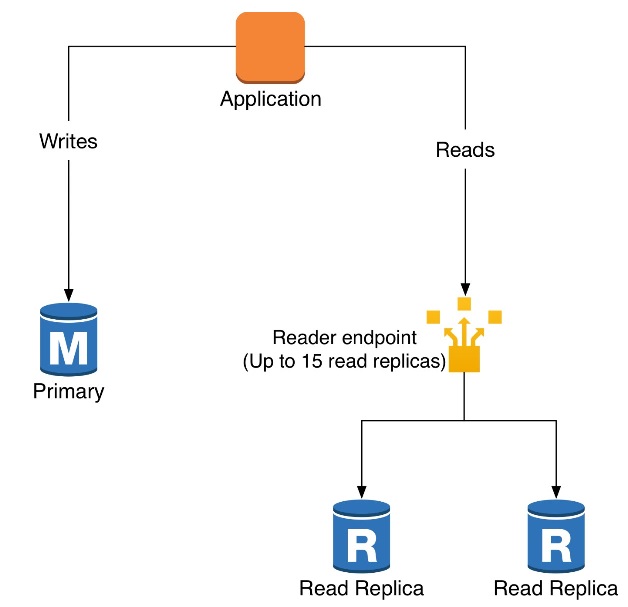
Writer는 단일 구조로 트랜잭션 커밋을 담당한다.
Reader는 최대 15개로 동일 스토리지를 공유한다. Read Scaling 전용
Endpoint는 Writer Endpoint, Reader Endpoint(로드밸런싱), Custom Endpoint(워크로드 분리)
failover가 빠른이유 #
rds는 replica promotion 스토리지 상태 재확인, crash recovery를 수행한다.
aurora는 스토리지는 이미 일관상태이므로 새로운 인스턴스가 스토리지에 attach. redo repay를 최소화 한다.
| 항목 | Aurora |
|---|---|
| 쓰기 지연 | 낮고 안정적 |
| Read 확장 | Reader 수평 확장 |
| Replica 지연 | 거의 없음 |
| Failover | 빠름 |
| 대용량 데이터 | 유리 |
| OLTP | 매우 강함 |
aurora는 단건 초저지연 트랜잭션, 단일 az, local ssd기반 mysql과 비교, write-heavy + small data 환경에서 약하다.
aurora 분산 신뢰성 + 확장성에 최적화된 디비인것
Quorum #
Writer Reader(1, 최대15)가 의미하는 바는 컴퓨터 인스턴스 개수를 의미한다.
위에서 6중 복제 / 6중 4 write / 3 read quorum이라는 내옹이 있었는데. 여기서 쿼럼은 스토리지 노드의 합의 규칙을 말하는거고 전혀 다른 대상이다.
quorum은 6중 복제 스토리지 내부 규칙이다.
Storage Node A (AZ1)
Storage Node B (AZ1)
Storage Node C (AZ2)
Storage Node D (AZ2)
Storage Node E (AZ3)
Storage Node F (AZ3)
Write quorum 6중 4는 writer 인스턴스가 redo log를 보낼때 4개 스토리지 노드가 ack하면 commit 성공
read quorum 6중 3은 스토리지에서 page / log를 읽을때 3개만 일치하면 읽기가 가능하다.
중요한것은 reader 인스턴스가 15개라고 해서 quorum이 15개가 되는것이 아니다 quorum은 스토리지 노드 기준
Client
  ↓
[Writer Instance]  ← 단 1개
  ↓
[6 Storage Nodes]
  ↳ 4개 ACK → commit

Client
  ↓
[Reader Instance #1]
[Reader Instance #2]
...
[Reader Instance #15]
  ↓
[동일한 6 Storage Nodes]
  ↳ 3개 일치 → read
그리고 writer를 여러개 두지 않는 이유는 분산 락, 분산 트랜잭션이 필요하고 write write conflict가 나니까 비용과 복잡도 급증 때문에 선택한거다
write는 단일화, read는 수평 확장하기로
| 오해 | 실제 |
|---|---|
| Reader가 많으면 quorum도 많아진다 | ❌ |
| Writer = Storage | ❌ |
| Replica는 복제본이다 | ❌ (같은 스토리지) |
| Aurora는 멀티 writer DB다 | ❌ (기본은 단일 writer) |