Redis Architecture
레디스 인스턴스에 접속했다면, redis cli를 통해 command를 전달해 데이터를 저장하거나 조작할 수 있다.
redis는 인메모리 데이터 구조 저장소로 아래 그림에서 해당되는 데이터 구조는 모두 메모리에 상주한다.
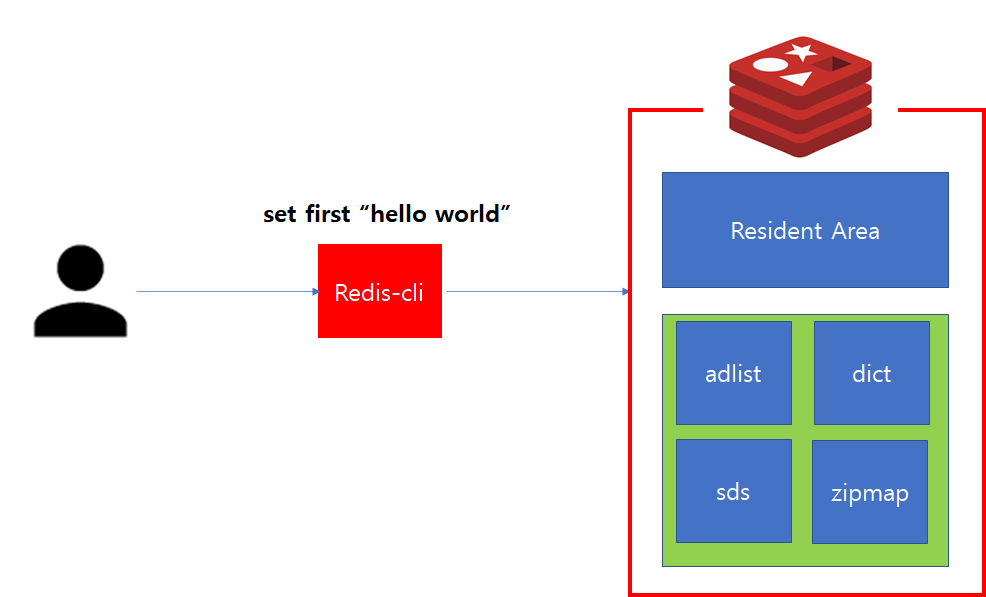
위 구조에서 Resident Area는 명령어를 통해 실제 데이터가 저장 및 작업이 수행되는 공간이다.
초록 영역은 내부적으로 서버 상태를 저장하고 관리하기 위한 메모리 공간으로 사용되며, Data Structure 영역이라고 불린다.
Redis Architecture #
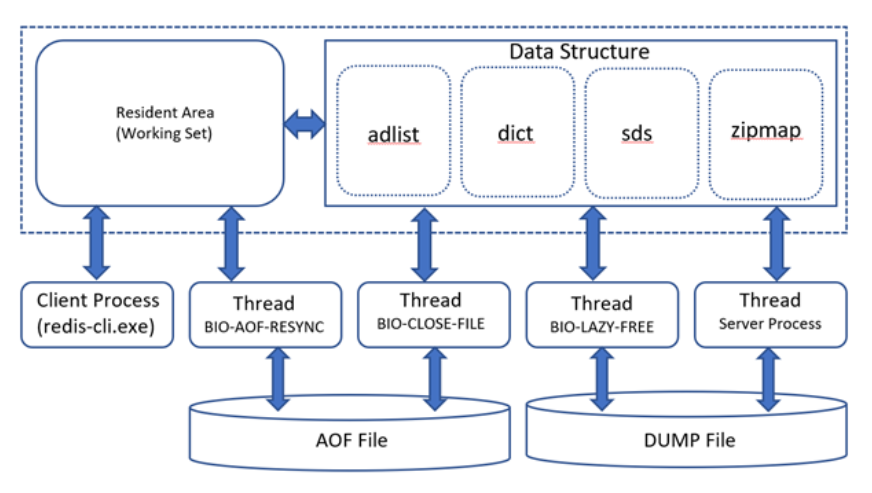
위에 사진이 Redis 기본 아키텍처 구조를 더욱 상세회한 것이며 3가지 영역으로 구성되어 있다.
메모리 영역 #
- Resident Area: 이 영역은 사용자가 Redis 서버에 접속해서 처리하는 모든 데이터가 가장 먼저 저장되는 영역이며 실제 작업이 수행되는 공간이고 WorkingSet 영역이라고 표현한다.
- Data Structure: Redis 서버를 운영하면서 발생하는 다양한 정보, 상태를 모니터링하기 위해 수집한 정보를 저장하고 관리하기 위한 메모리 공간이 필요하다. 이를 저장하는 메모리 영역을 Data Structure 영역이라고 한다.
파일 영역 #
- AOF File: Redis에서 데이터 복구를 위해 사용되는 AOF 방식으로 생성된 파일들을 저장한다
- DUMP File: 사용자 데이터를 디스크 상에 저장할 수도 있지만 소량의 데이터를 일시적으로 저장할 때 사용되는 파일은 DUMP 파일이다 (RDB 방식)
프로세스 영역 #
- Server Process: redis-server.exe or redis-sentinal.exe는 실행 코드에 의해 활성화되는 프로세스를 서버 프로세스라고 한다. Redis 인스턴스를 관리해주며 사용자가 요구한 작업을 수행하는 프로세스다. redis server 프로세스는 main thread, sub thread 1(BIO-Close-File), sub thread 2(BIO-AOF-Resync), sub thread3(BIO-Lazy-Free) 4의 멀티 스레드로 구성된다.
- main thread: redis 서버에서 수행되는 대부분의 명령어와 이벤트 처리
- sub thread 1: AOF 데이터를 rewrite할 때 기존 파일은 Close하고 새로운 AOF 파일을 write할 때 사용
- sub thread2: AOF 쓰기 작업 수행시 사용
- sub thread3: UNLINK, FLUSHALL, FLUSHDB 같은 명령어를 실행할 때 더 빠른 성능을 보장하기 위해 백그라운드에서 사용됨
- Client Process: redis-cli.exe 또는 사용자 애플리케이션에 의해 실행되는 명령어를 실행하기 위해 제공되는 프로세스
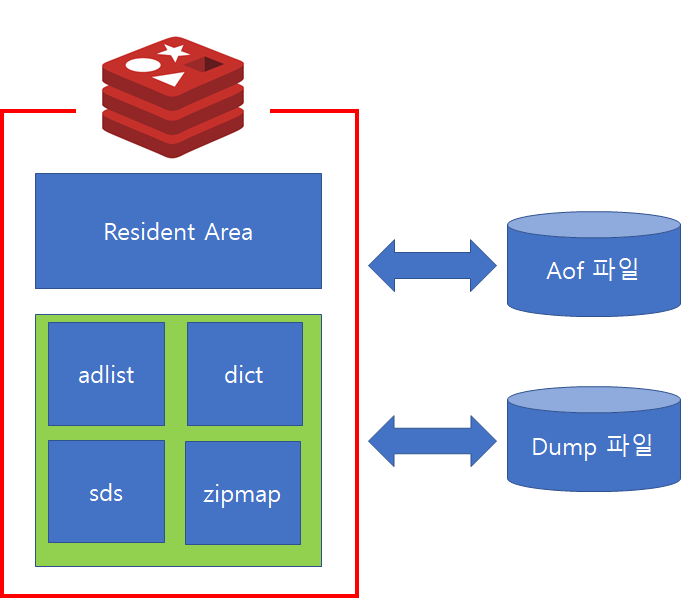
redis는 인메모리 데이터 구조 저장소다 그러나 memory는 휘발성 데이터기이 때문에, 프로세스를 종료하게 되면 데이터는 모두 유실된다. 따라서 단순 캐시용도가 아닌 Persistence 저장소로 활용하기 위해서는 disk에 저장하여 유실이 발생하지 않도록 해야한다.
이를 위해서 AOF(Append Only File) 기능과 RDB(Snapshot)기능을 사용한다.
AOF는 전달된 명령어를 별도의 파일로 기록하는 방법으로 RDBMS의 redo 방식과 유사하다.
AOF의 역할은 재기동시 파일에 기록된 명령어를 일괄 수행하여 데이터를 복구하는데 사용된다.
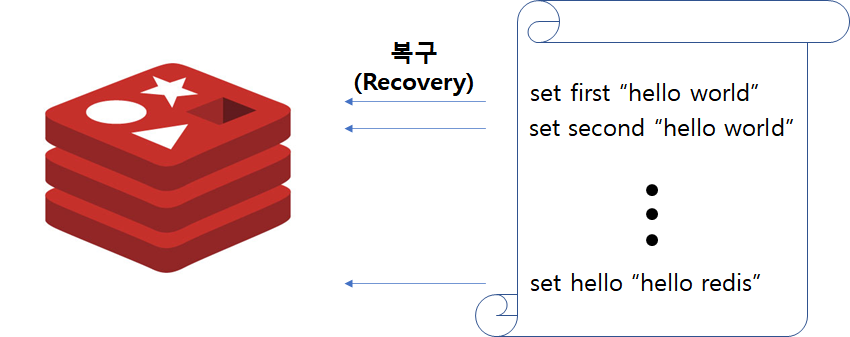
AOF 장점으로는 데이터 유실이 발생하지 않는다. 그러나 매 명령어마다 file에 동기화가 필요하기 때문에 처리속도가 현격히 줄어들 수 있다. 그래서 이를 해소하기 위해서 file sync 옵션(appendfsync)이 존재하며 sync 주기를 적절히 조절할 수 있다. 그러나 조절하는 만큼 유실이 발생할 수도 있다.
반면 RDB는 특정 시점의 메모리 내용을 복사하여 파일에 기록하는 방법이다. RDBMS Full Backup에 해당되며, 따라서 정기적 혹은 비정기적으로 저장이 필요한 시점에 데이터 저장이 가능하다.
RDB 장점으로는 AOF에 비해서 부하가 적으며, LZF 압축을 통해 압축이 가능하다. 또한 덤프파일을 그대로 메모리에 복원하므로 AOF에 비해 빠르다. 반면, 덤프를 기록한 시점 이후 데이터는 저장되지 않아 복구시 데이터 유실이 발생할 수 있다.
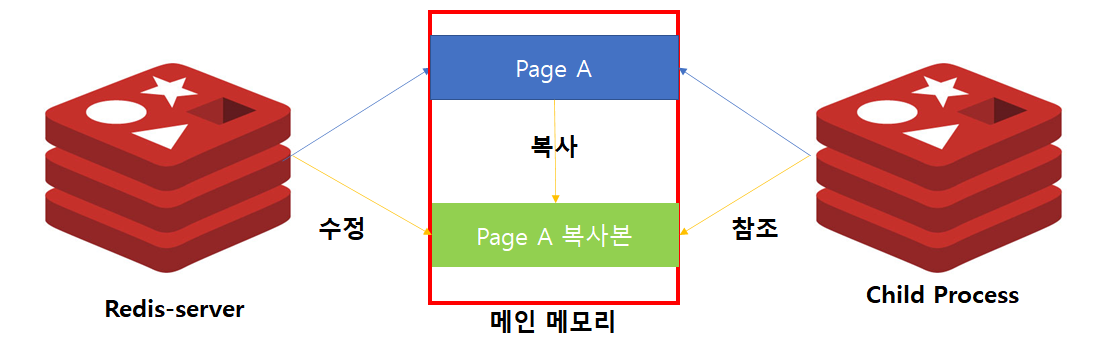
주의점 #
AOF, RDB에서 가장 유의해야할 점은 Copy On Write다. AOF를 백그라운드로 수행하거나 RDB를 수행할 때 redis-server에서 자식 프로세스를 fork하여 처리를 위임한다. 이 과정에서 redis-server의 데이터에 쓰기 작업을 수행하면, 기존 페이지를 수정하는 것이 아닌 이를 별도 공간에 저장 후 처리한다. 따라서 해당 작업을 수행도중 쓰기 작업이 증가한다면, 메모리 사용량이 급격히 증가될 수 있다.
Master/Replica 동기화 과정 #
Redis Cluster 에서 master/replica 구조에서 동기화 과정을 살펴보겠다.
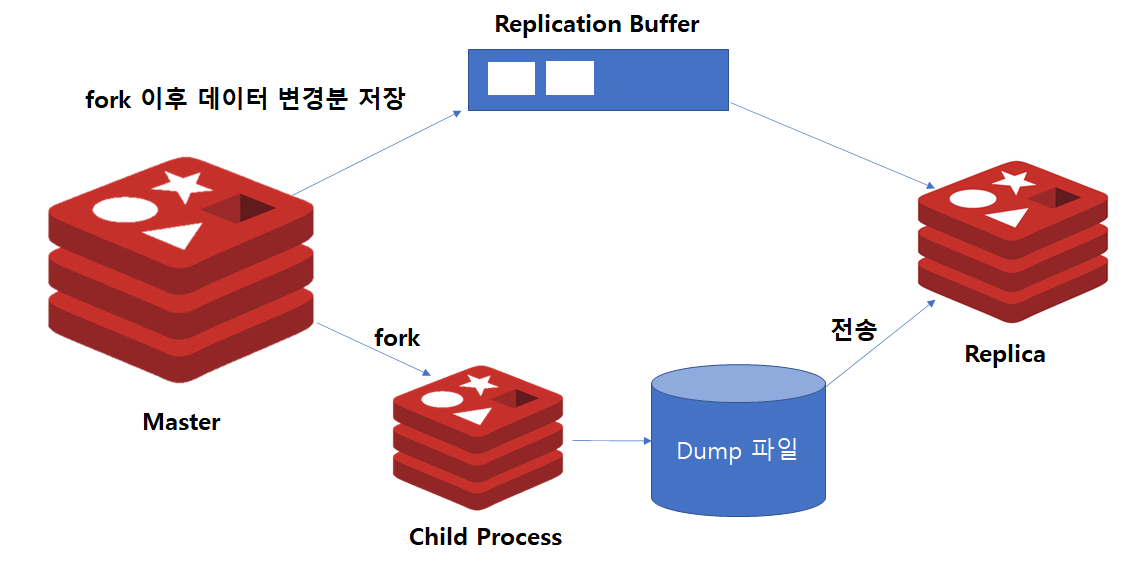
replica 노드에는 Master 노드에 적재된 데이터가 하나도 존재하지 않는다. 그래서 최초 구성시에는 전체 동기화가 발생한다. 전체 동기화 과정은 다음과 같다.
- master, replica 인스턴스를 별도로 구성한다.
- replica instance는
ReplicaOf명령어를 통해 master 인스턴스와 동기화 명령을 수행한다. - master에서는 fork를 통해 자식 프로세스를 생성한다.
- 자식 프로세스는 master 메모리에 있는 모든 데이터를 disk로 dump한다.
- dump가 완료되면, 이를 replica에 전달하여 반영한다.
- master에는 복제가 진행되는 동안 변경 데이터를 replication buffer에 저장한다.
- dump 전송이 완료되면, replication buffer의 내용을 replica에 전달하여 데이터를 최신상태로 만든다.
- 작업이 완료되면, 이후에 데이터 변경 발생분만 비동기 방식으로 전달한다.
따라서 최초 구성시에는 Full Sync가 발생하고, 이 때 fork가 발생하므로 메모리 사용량이 증가할 수 있다.
만약 master/replica 구성이 완료된 이후 네트워크 지연이 발생되면 동기화 처리는 어떻게 될까?
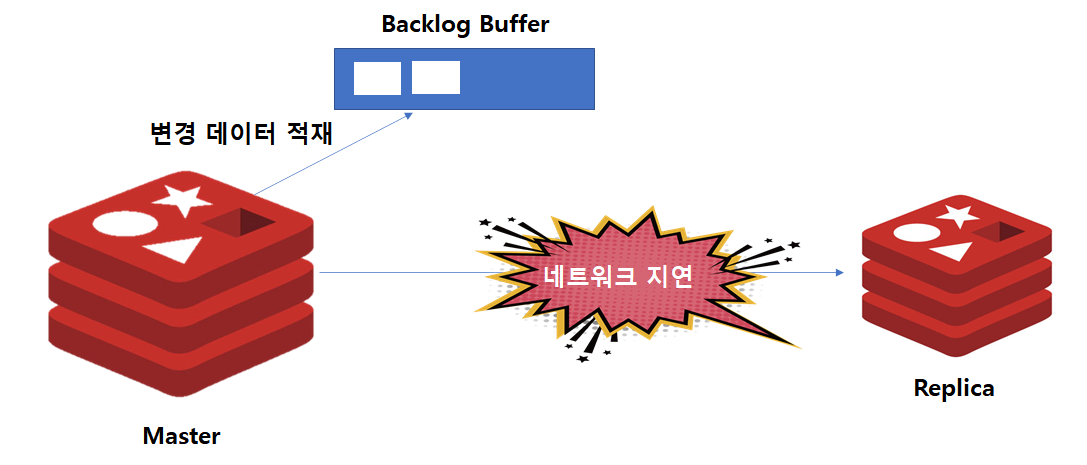
ReplicaOf 명령어를 통해 master/replica 구조가 되면, master instance에서는 내부적으로 repl-backlog-size옵션 만큼의 Backlog Buffer가 만들어진다. 이후 replica와의 단절이 발생하면 마스터 인스턴스에서는 변경 데이터를 Backlog Buffer에 저장한다. Backlog Buffer는 유한한 크기를 지녔으므로, 지연이 오랫동안 발생하면 버퍼가 넘칠 수 있다.
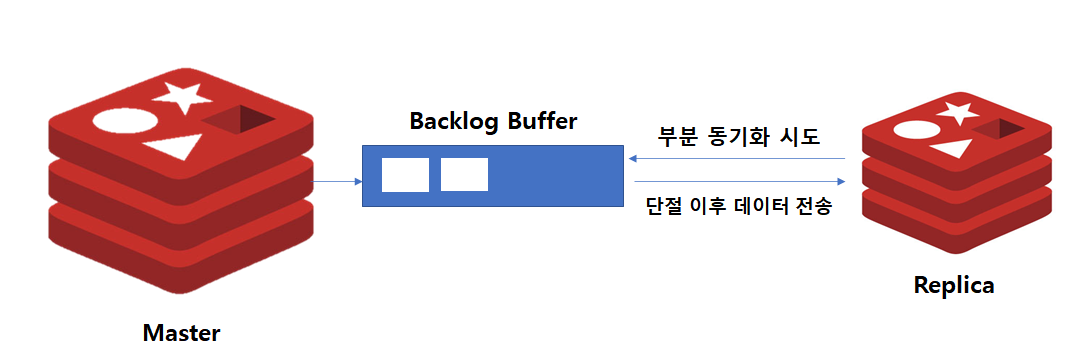
단절 이후 다시 재연결 되었을 때 과정은 위와 같다.
- Replica에서 master와 동기화를 위해 부분 동기화를 시도한다.
- 만약 Backlog Buffer에 네트워크 단절 이후의 데이터가 모두 존재하면, Buffer 데이터를 전달받아 최신 상태를 만든다.
- 만약 오랜 시간 네트워크 단절로 인해 Backlog Buffer값이 유실되었다면 다시 전체 동기화 과정을 진행한다.
AOF, RDB때도 설명했지만 프로세스 fork가 일어나면 COW 방식으로 사용되기 때문에 전체 동기화 혹은 replica 추가 작업시에는 모니터링과 메모리 조정등이 필요하다.