MongoDB
MongoDB는 기존에 사용하던 RDB의 확장성과 신속성 문제로 개발한 데이터베이스로
NoSQL의 한 종류이며, Document라는 형식의 자료구조를 사용하고있다.
[[NoSQL vs SQL]]의 차이는 여기서 보자
데이터 중복이 발생할 수 있지만 접근성과 가시성, 읽기 성능이 좋다.
생성, 수정, 삭제 시 각 컬렉션에 반영해야한다는 단점이 있다.
스키마 설계가 어렵지만, 스키마가 유연해서 애플리케이션 요구사항에 맞게 데이터를 수용할 수 있다.
HA와 Scale-Out Solution을 자체적으로 지원해서 확장에 용이하다.
즉 Application에서는 Scale-Out을 고려하지 않아도 된다.
Secondary Index를 지원한다.
다양한 종류의 Index를 제공하고있다.
인덱스에 관련해서는 나중에 언급해보도록 하겠다
인덱스를 정리하면 여기에 링크를 걸어주세요!
개념 #
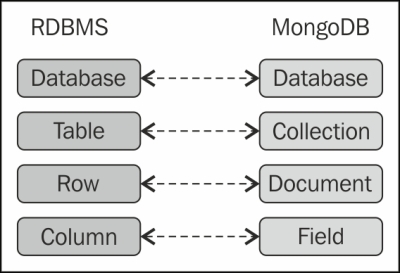
MongoDB가 RDBMS랑 대응되는 개념이다.
1. 기본 DataBase #
MongoDB는 아래 3개의 기본 데이터베이스를 제공한다. (루트 권한 여부에 따라서 안보일 수도 있다.)
- admin: 인증 인가 역할
- local: replication이 필요한 oplog와 같은 컬렉션 저장, 인스턴스 진단을 위한 startup_log와 같은 정보 저장, 복제대상에서는 제외
- config: sharded cluster에서 각 shard의 정보를 저장한다.
2. Collection #
동적 스키마를 가진다. 그래서 스키마를 수정하려면 값을 추가,수정,삭제만 하면된다. 스키마라는 개념이 없다고 보는 것이 좋을 듯?
- Collection을 단위로 인덱스를 생성할 수 있다.
- Collection을 단위로 Shard를 나눌 수 있다.
- 즉, Index나 Sharding Key 등의 활용을 하기 위해서는 Schema를 어느정도 유지를 해줘야한다.
3. Document #
데이터를 저장할 때 BSON(Binary-JSON) 형태로 저장한다.
JSON보다 텍스트 기반 구문 분석이 빠르며 공간이 효율적이다.
모든 Document에는 _id 필드가 존재하고, 없이 생성하면 고유한 ObjectId를 저장한다.
생성시 상위 구조인 DataBase, Collection이 없다면, 먼저 생성하고 Document를 생성한다.
최대 크기는 16MB로 고정되어있다.