LSM Tree
Log Structured Storage Engine #
Document DataBase는 데이터가 문서 자체에 포함되어 있어 하나의 문서가 다른 문서간 관계가 없는 사용 사례를 대상으로 한다.
대표적으로 logfile에 값을 write하는 Log Structured Storage Engine 방식이 있고 로그는 특정 값을 수정하는 것이 아닌 새로운 값을 그대로 추가하는 append-only 방식이다. 그렇기에 write throughtput이 o(1)이고 read throughtput이 o(n)이다. 전반적으로 쓰기가 빠르고 읽기가 느리다는 것을 볼 수 있다.
그래서 우리는 log structured storage engine의 read throughput을 높이기 위하여 index를 만들어 조회 성능을 높혀야한다.
Hash Index #
hash function을 이용해 각 항목의 키 값을 해시코드로 변환하고, 이 해시코드를 인덱스로 사용해 데이터를 빠르게 찾을 수 있게 해준다. 각각의 key안에 value들은 실제 데이터가 disk에 저장되어있는 위치인 byteoffset을 저장하고 있으며 hash index를 통해 빠르게 byteoffset으로 접근하여 조회 성능을 올릴 수 있다.
속도 #
- 조회 속도: Hash Index의 조회 속도는 평균적으로 key에 속한 element의 개수가 하나라면 O(1)이고 해시 함수를 사용하여 키 값을 해시코드로 변환하고, 이 해시 코드를 바탕으로 데이터의 위치를 찾을 수 있기 때문에 정말 빠르게 조회가 가능하다.
- 쓰기 속도: Hash Index의 쓰기 속도는 평균적인 경우 O(1)이고, 새로운 데이터를 추가할 때 새로운 해시 함수를 통해 계산된 위치에 데이터를 저장하기 때문에 빠른 처리가 가능하다. 그러나 해시 테이블에서 해시키 충돌이 발생하면 추가적인 시간이 소요될 수 있으며, 이는 최악의 경우 O(n)까지 증가할 수 있다.
하지만 이런 Hash Index도 단점이 존재한다.
- 해시 값을 인덱스로 활용하기 때문에 원본 데이터를 활용하는 연산이 어렵다(sort, range 연산)
- 유니크한 데이터에게 최적화된 인덱스라고 볼 수 있다.
- HashMap에 모든 키를 메모리에 전부 담아야한다.
이러한 해결법은 LSM Tree를 통해 해결하는데 그 전에 segement에 대해서 먼저 알아보겠다.
Segment #
log structured storage engine에서 데이터를 append-only 방식으로 저장하다보면 나중에는 디스크 공간이 부족해지기 때문에 데이터를 읽을때마다 full scan을 해야하는 입장에서는 매우 높은 성능 저하가 예상된다.
그렇기 때문에 일정한 크기에 데이터가 logfile에 저장된다면 데이터를 특정 크기의 segment로 나누게 되고 active하지 않은 데이터, 세그먼트를 컴팩션하는 과정도 거친다.
여기서 active 세그먼트는 현재 데이터가 쓰여지고 있는(최신의) 세그먼트를 의미한다. 컴팩션은 append only 방식으로 같은 키의 데이터들이 여러개 들어왔다면 가장 최신의 데이터만 남기고 유효하지 않게 되거나 최신값으로 대체될 수 있는 데이터들이 차지하고 있는 공간을 merge하거나 삭제하는 방식으로 정리한다.
LSM Tree(SSTable) #
hash index의 단점으로는 range query가 불가능하단 점, 메모리에 모든 index를 올려야한다는 점이 있다. 이걸 보완하기 위해 우리는 LSM Tree를 사용하고 LSM Tree는 SSTable(Sorted String Table), memtree를 사용한다.
SSTable은 Segment와 다르게 저장된 바이트 오프셋의 위치가 저장된 해시맵의 키가 정렬되어있는 구조다. 정렬된 구조기 때문에 범위 검색을 지원하고 또 한 번 디스크에 쓰여지면 SSTable immutable하다.
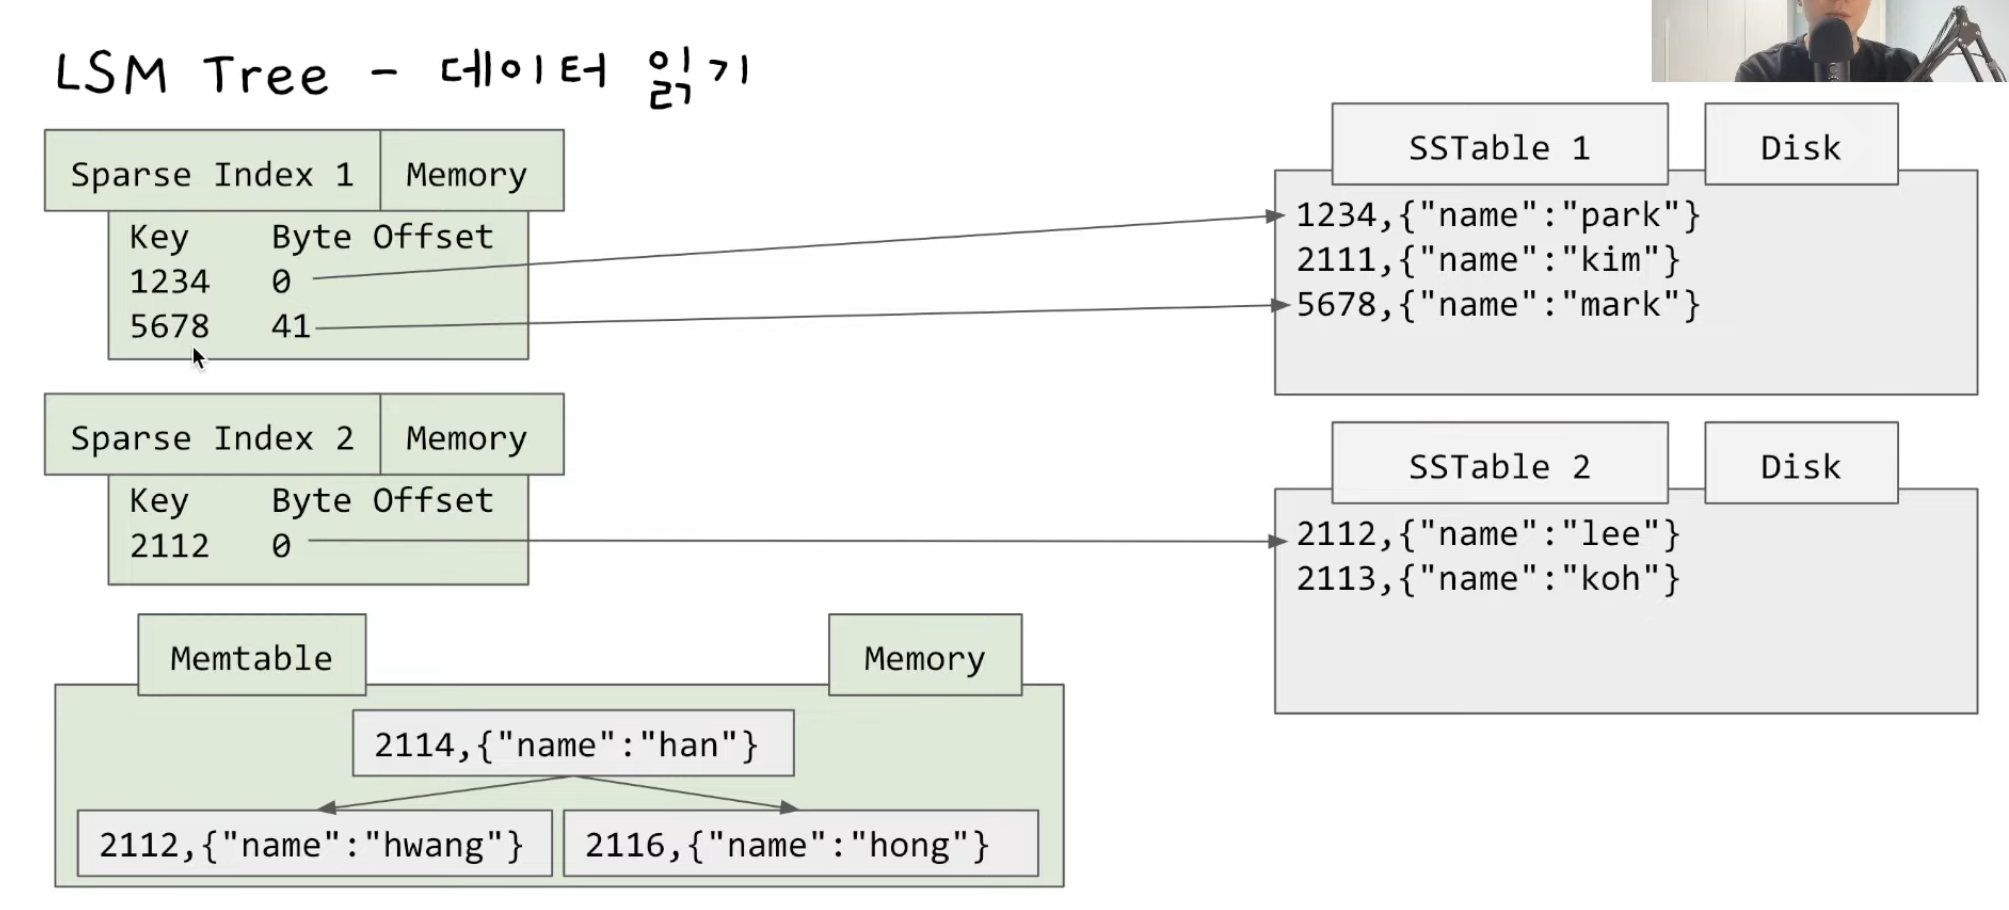
LSM Tree의 memtable은 balanced binary tree를 이루며 정렬되어있고 특정 사이즈만큼 커지면 sstable에 flush하는 방식으로 되어있다.
모든 쓰기 작업은 memtable을 통해서 진행된다. memtable은 메모리에 위치하므로 데이터베이스 쓰기 연산은 매우 빠르게 처리될 수 있다 disk io가 없으니까!
근데 만약 memtable에 데이터가 있고 sstable에 아직 flush하기 전에 memory가 crash 된다면 어떻게 될까? 데이터가 모두 날아가는 것일까?
그렇지 않다 memtable에 write할때 sstable이 아닌 알반적인 logfile에도 데이터를 함께 기록한다. 이때는 sstable처럼 정렬되어있지 않다. 그리고 crash가 날때 이 logfile을 통해서 데이터를 복구한다. LSM Tree의 logfile은 오직 data backup 용도로만 사용된다.
그리고 SSTable은 segement처럼 분리되어있는 형식으로 이루어져있는데 너무 많이 분리가 된다면 더 많은 DiskIO가 발생하므로 일정 갯수로 분리가 된다면 각각의 sstable을 merge하여 관리한다. sorted 되어있기 때문에 merge 성능이 매우 좋다.
결과적으로 LSM Tree는
- Write가 빠르다. Memtable과 logfile만 업데이트하면 끝
- Sparse Index
- memtable이 모든 키 값을 가지고 있지 않아도 돼 적은 공간 활용
- 하지만 주어진 레코드를 찾는데 키를 안갖고 있으면 시간이 더 걸리긴함
- sstable은 정렬되어있는 상태기 때문에 컴팩션 과정에서 merge하기 쉬움
그러나 단점으로는
- compaction 과정에서 SSD 쓰기 증폭으로 인해 오버헤드 발생
- SSD의 쓰기 증폭을 줄이기 위해서 compaction을 최소화 할 것인가 읽기 최적화를 위해서 compaction을 자주할 것인가에 대한 고민 필요