B-Tree
B-Tree 자료구조에 대해서 알아보도록 하겠습니다.
일단 B-Tree는 Balanced Tree들 중에 하나로 모든 리프 노드들이 같은 레벨을 가질 수 있도록 자동으로 밸런스를 맞추는 트리입니다.
실제 DB에서는 B-Tree 발전해서 B+Tree를 사용합니다.
특징 #
- 자녀 노드의 최대 개수를 늘리기 위해서 부모 노드에 key를 하나 이상 저장합니다.
- 부모 노드의 key들은 오름차순으로 정렬합니다.
- 정렬된 순서에 따라 자녀 노드들의 key 값의 범위가 결정됩니다.
최대 몇 개의 자녀 노드를 가질 것인지가 B-Tree를 사용할 때 중요한 파라미터입니다.
여기서 M을 각 노드의 최대 자녀 노드 수라고 해보겠습니다.
최대 M개의 자녀를 가질 수 있는 B Tree를 M차 B Tree라고 합니다.
여기서 각 노드의 최대 key 수는 M - 1 입니다.
각 노드의 최소 자녀 노드 수는 ⌈ M / 2 ⌉ 입니다. (2로 나눈 값을 무조건 올림함 ex 1.5 -> 2)
각 노드의 최소 key의 수는 ⌈ M / 2 ⌉ - 1 입니다. 이 조건은 leaf node와 root node는 제외됩니다.
정리해보면
- M | 각 노드의 최대 자녀 노드 수
- M - 1 | 각 노드의 최대 key 수
- ⌈ M / 2 ⌉ | 각 노드의 최소 자녀 노드 수
- ⌈ M / 2 ⌉ - 1 | 각 노드의 최소 key 수
그리고 추가로 internal node의 key수가 x라면 자녀 노드의 수는 언제나 x + 1개여야한다.
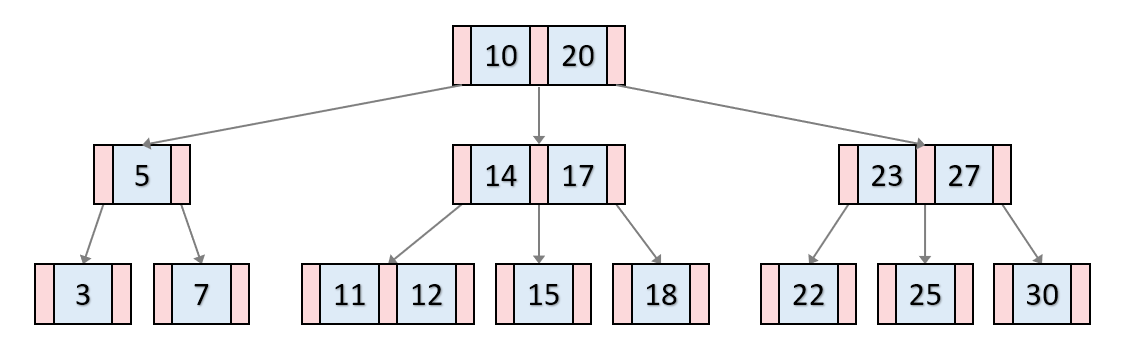
노드가 최소 하나의 key는 가지기 때문에 몇 차 B Tree 인지는 상관 없이 internal node는 최소 두 개의 자녀를 가진다.
B Tree key 검색 과정 #
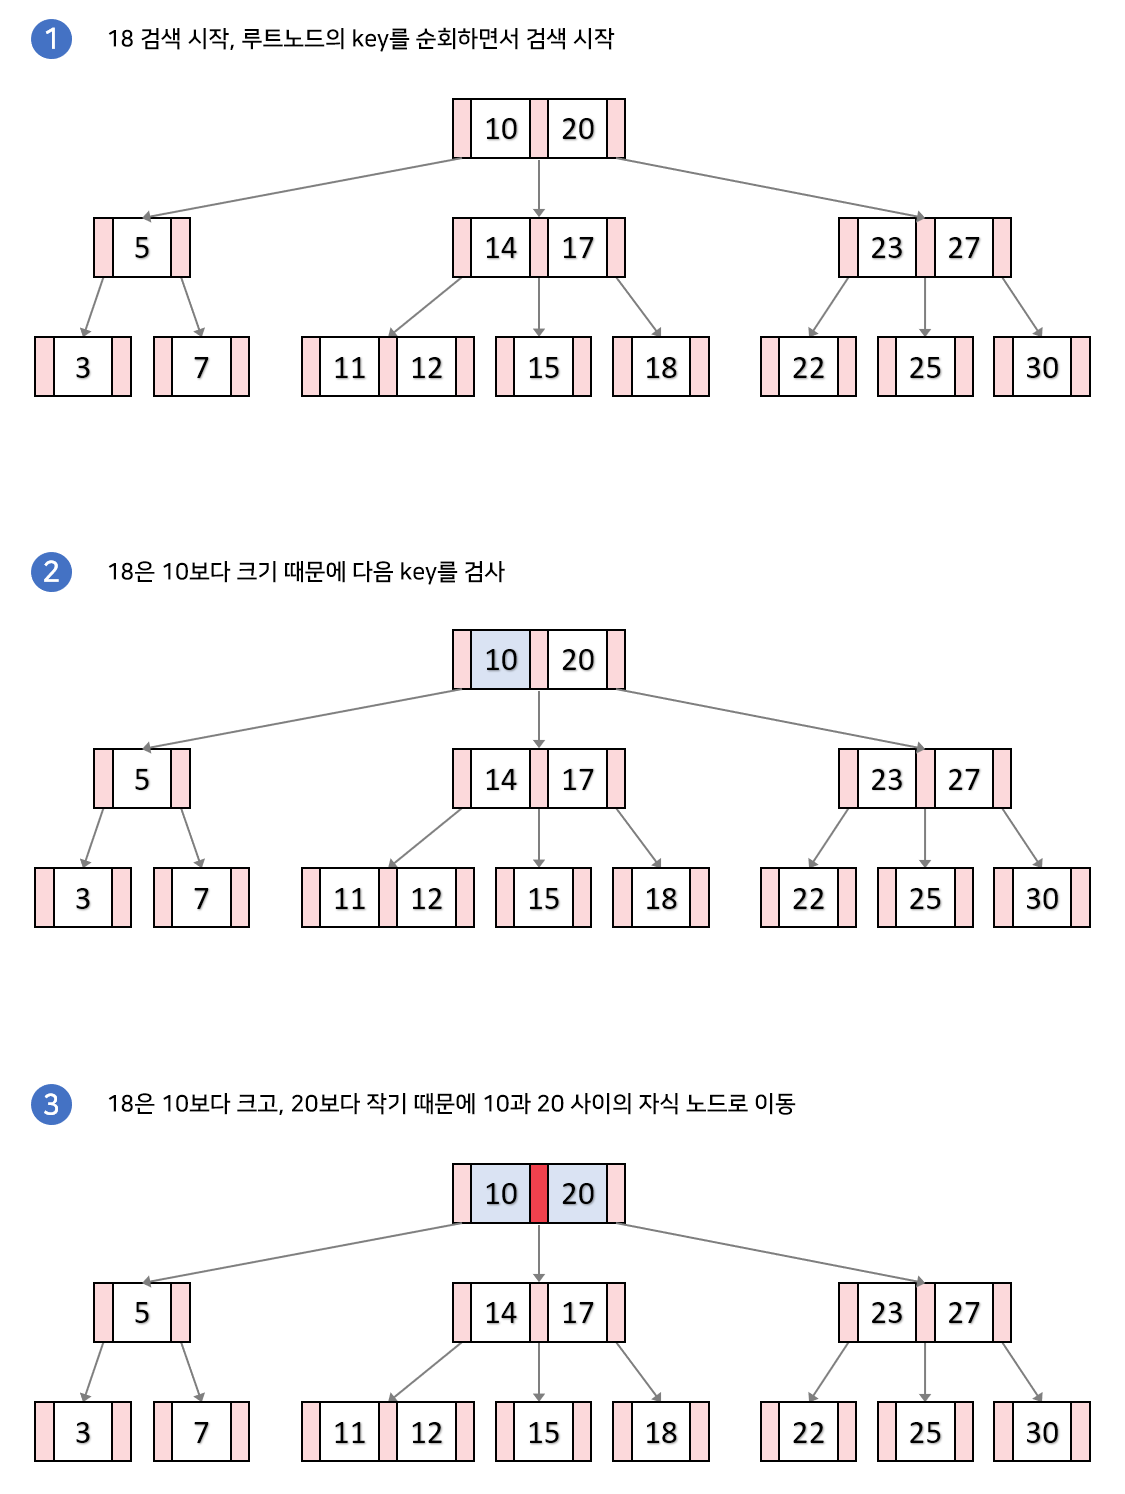
루트노드에서 시작해서 하향식 검색을 수행한다.
검색하고자하는 key를 k라고 하였을 때 검색하는 과정이다.
- 루트 노드에서 시작해 key들을 순회하면서 검사한다.
- 만약 k와 같은 key를 찾았다면 검색을 종료한다.
- 검색하는 값과 key의 대소관계를 비교한다. key들 사이에서 k가 들어간다면 해당 key들 사이의 자식 노드로 내려간다.
- 위의 과정을 리프 노드에 도달할 때까지 반복한다 만일 리프노드에도 k와 같은 key가 없다면 검색을 실패한다.
B Tree 데이터 삽입 #
데이터 추가는 항상 leaf node에 하게 된다.
노드가 넘치괴 되면 가운데(median) key를 기준으로 좌우 key 들을 분할하고 가운데 key는 승진한다.