Kafka Replication 작동 원리
카프카 리플레케이션 동작 #
메인 허브의 역할을 하는 카프카 클러스터가 정상적으로 동작하지 못하면 매우 심각한 문제가 발생할 수 있다. 그래서 카프카에서는 고가용성을 위해 초기 설계 단계부터 안정적인 서비스를 운영하도록 리플리케이션이라는 동작을 한다.
카프카는 브로커의 장애에도 불구하고 연속적으로 안정적인 서비스를 제공함으로써 데이터 유실을 방지하고 유연성을 제공한다. 토픽 생성시에 아래와 같이 replication factor 라는 옵션을 설정해야한다.
생성 후에 describe 명령어로 상세보기를 실행한다.
> --create --topic peter-test01 --partitions 1 --replication-factor 3

[출력]
Create topic peter-test01
> --bootstrap-server peter-kafka01.foo.bar:9092 --topic peter--test01 --describe

[출력]
Topic: peter-test01 PartitionCount: 1 ReplicationFactor: 3 Configs : segment.bytes=1073741824
Topic: peter-test01 Partition : 0 Leader 1 Replicas :1,2,3 Isr : 1,2,3
- PartitionCount: 토픽의 파티션 개수
- ReplicationFactor: 리플리케이션 팩터 수
- Partition : 0 Leader : 1 Replicas : 1, 2, 3, lsr: 1,2,3: 리더는 브로커 1을 나타낸다 리플리케이션들은 브로커 1,2,3에 있고 현대 동기화 하고 있는 리플리케이션들은 브로커 1,2,3 이라는 의미다. ISR(In Sync Replica)
peter-test01 topic으로 test message1 이라는 메세지를 전송하고 세그먼트 파일의 내용을 확인하면, 3대의 브로커가 동일한 메시지를 가지고 있는 것을 확인할 수 있다.
replication factor라는 옵션을 통해서 관리자가 지정한 수 만큼 리플리케이션을 가질 수 있어 n개의 리플리케이션이 있는 경우 n-1 까지의 브로커 장애가 발생해도 메시지 손실 없이 안정적으로 주고받을 수 있다.
일반적으로 3개의 리플리케이션을 권장한다.
Leader, Follower #
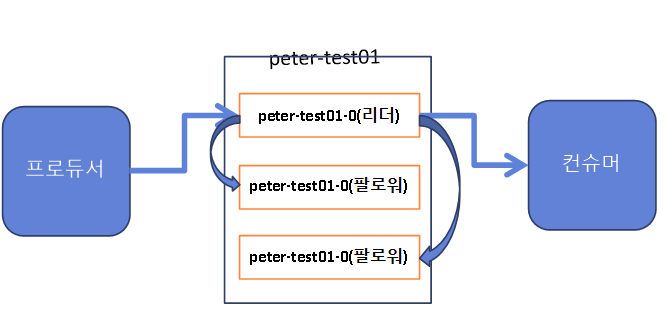
파티션의 리더는 리플리케이션 중 하나가 선정되어, 모든 읽기 쓰기가 그 리더를 통해서만 처리될 수 있다. 프로듀서는 리플리케이션에게 메시지를 보내는 것이 아니라 리더에게만 메시지를 전송하고 컨슈머는 리더로부터 메시지를 가져온다. 프로듀서가 peter-test01 토픽으로 메시지를 전송하고, 파티션의 리더만 읽고 쓰기가 가능하므로 리더에게 메시지 전송, 컨슈머 동작에서도 0번 파티션의 리더에게만 메시지를 받는다.
이 때 팔로워들은 대기하는 것이 아닌, 리더가 문제가 발생하거나 이슈가 있을 경우 언제든지 새로운 리더가 될 준비를 한다. 팔로워는 파티션의 리더가 새로운 메시지를 받았는지 확인하고, 새로운 메시지가 있다면 해당 메시지를 리더로부터 복제한다.
복제 유지와 커밋 #
리더와 팔로워 간 복제 동작이 어떻게 이루어지는가? 리더와 팔로워는 ISR(In Sync Replica)라는 논리적 그룹에 묶여있다. 이 그룹에 속한 팔로워만이 새로운 리더가 될 자격을 가진다. ISR 내의 팔로워들은 리더와의 데이터 일치를 유지하기 위해 지속적으로 리더의 데이터를 따라가게 되고, 리더는 ISR 내의 모든 팔로워가 메시지를 받을 때까지 기다린다. 하지만 오류가 발생해서 리더로부터 데이터를 못 받는 경우가 발생할 수 있다. 이때 이 팔로워들에게 리더를 넘겨주면 메시지 손실이 발생할 수 있다.
리더는 읽기 쓰기 말고도 팔로워가 리플리케이션 동작을 잘 수행하는지 검사한다. 팔로워가 특정 주기 시간만큼 복제 요청을 하는가를 판단하여 그렇지 않다면 팔로워가 문제가 발생했다 판단하여 ISR 그룹에서 추방시킨다.
앞서 했던 describe 명령어를 통해서 ISR 목록을 확인하여 상태 점검을 할 수 있다.
ISR 내에서 모든 팔로워의 복제가 완료되면 리더에서 commit을 표시해준다. (리플리케이션 모두 메시지 저장) 마지막 커밋 오프셋의 위치는 high water mark라고 부른다. 메시지의 일관성을 위해 커밋된 메시지만 컨슈머가 읽을 수 있다.
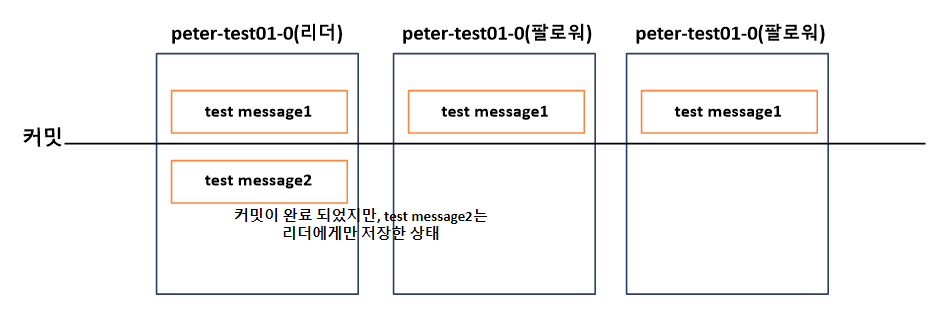
커밋되기 이전 메시지를 컨슈머가 읽을 수 있다면?
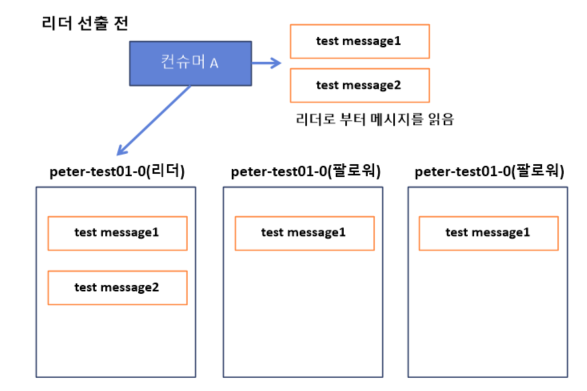
각기 다른 컨슈머가 메시지를 컨슘하는 동안 파티션의 리더 선출이 발생하는 경우라면?
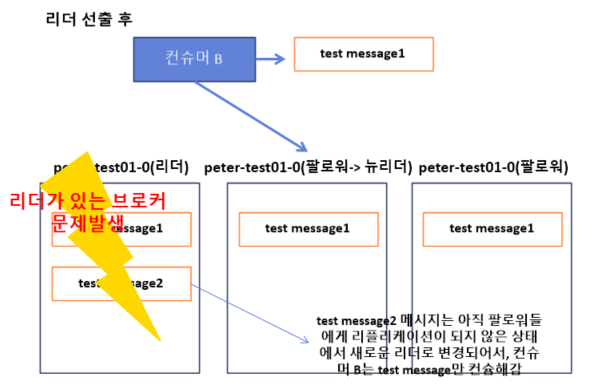
-> 커밋되지 않은 메시지를 컨슈머가 읽을 수 있게 허용해버리면, 동일한 토픽의 파티션에서 컨슘했을 때도 메시지가 일치하지 않는 현상이 발생할 수 있다. 따라서 커밋된 메시지만 컨슈머가 읽을 수 있도록 구현되어있다.
커밋된 위치가 중요하다.
커밋된 위치를 알 수 있는 방법이 무엇일까? 모든 브로커가 재시작될 때, 커밋된 메시지를 유지하기 위해 로컬 디스크의 replication-offset-checkpoint라는 파일에 마지막 커밋 오프셋 위치를 저장한다. 이 파일의 내용을 확인하고 리플리케이션되고 있는 다른 브로커들과 비교해 살펴보면, 어떤 브로커, 토픽, 파티션에 문제가 있는지 파악이 가능하다.
리더에 포크 과정을 통해 복구 과정에 대해서 알 수 있다.
Leader와 Follower의 단계별 리플리케이션 동작 #
앞서 본 것처럼 리더는 수많은 메시지를 읽고 쓰고, 팔로워의 리플리케이션 동작을 감시하며 매우 바쁘게 동작한다. 리더가 리플리케이션 동작을 위해 팔로워들과 많은 통신을 주고받거나 리플리케이션 동작에 많은 관여를 하면, 결과적으로 리더의 성능이 떨어져 카프카의 장점인 빠른 성능을 내기 힘들다.
-> 리더 팔로워 간의 리플리케이션 동작을 처리할 때 서로의 통신을 최소화하도록 설계해 리더의 부하를 줄여야한다.
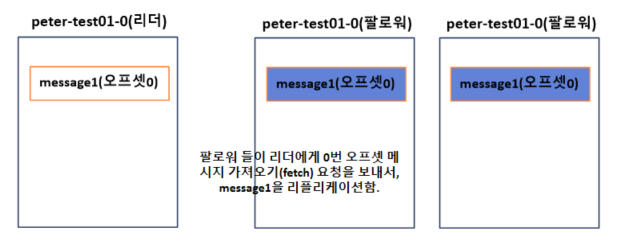
현 상태는 리더는 모든 팔로워가 0번 오프셋 메시지를 리플리케이션하기 위한 요청을 보냈다는 사실을 알고 있다. 하지만 리더는 팔로워들이 0번 오프셋에 대한 리플리케이션 동작이 성공했는지에 대한 여부를 알 수 없다.
그럼 리더는 어떻게 팔로워들의 리플리케이션 동작 여부를 확인할 수 있을까?
RabbitMQ는 Ack를 통해 메시지를 받았는지 알 수 있으나 카프카는 이런 ack를 없애 리플리케이션 동작 성능을 높혔다.
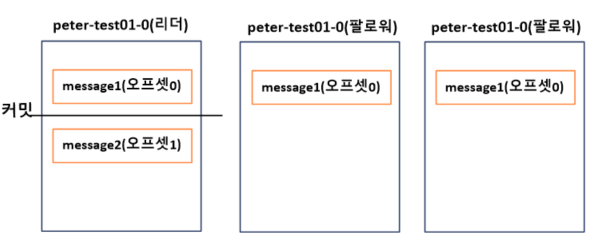
리더는 1번 오프셋의 위치에 새로운 메시지 message2를 프로듀서로부터 받은 뒤 저장한다. 0번 오프셋에 대한 리플리케이션 동작을 마친 팔로워들은 리더에게 1번 오프셋에 대한 리플리케이션을 요청한다. 팔로워들로부터 1번 오프셋에 대한 리플리케이션 요청을 받은 리더 팔로워들의 0번오프셋에 대한 리플리케이션 동작을 성공했음을 인지하고, 오프셋 0에 대한 커밋 표시를 한 후 하이워터마크를 증가시킨다.
팔로워가 0번 오프셋에 대한 리플리케이션을 성공하지 못했다면, 팔로워는 1번 오프셋에 대한 리플리케이션 요청이 아닌 0번 오프셋에 대한 리플리케이션 요청을 보내게 된다. 따라서 리더는 팔로워들이 보내는 리플리케이션 요청 오프셋을 확인하고, 팔로워들이 어느 위치의 오프셋까지 리플리케이션을 성공했는지 인지할 수 있다.
팔로워들로부터 1번 오프셋 메시지에 대한 리플리케이션 요청을 받은 리더는 응답에 0번 오프셋 message1 메시지가 커밋되었다는 내용도 함께 전달한다.
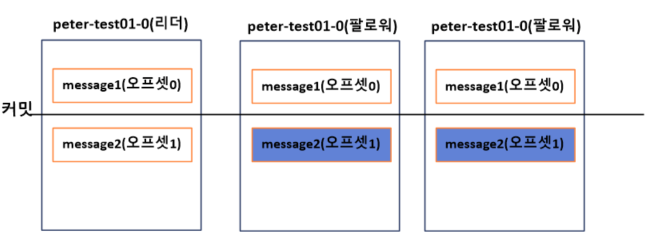
리더의 응답을 받은 모든 팔로워는 0번 오프셋 페이지가 커밋되었다는 사실을 인지하게 되고, 리더와 동일하게 커밋을 표시한다. 그리고 1번 오프셋 메시지인 message2를 리플리케이션한다.
이렇게, 리더와 폴로워는 일련의 과정을 반복하여 동일한 파티션 내에서 리더와 팔로워 간 메시지의 최신 상태를 유지한다.
카프카는 대량의 메시지를 처리하려는 목적을 가진 애플리케이션이기 때문에 RabbitMQ와 같은 메시징 시스템의 ack를 통해 통신하는 방식은 성능상 문제가 발생할 수 있다. 따라서 카프카는 이러한 통신 방식을 제외하여 메시지를 주고받는 기능에만 집중한다는 장점이 있다.
또한 리더와 팔로워 간의 리플리케이션 동작이 매우 빠르게 신뢰할 수 있다는 장점도 존재한다.
카프카에서 리더가 push하는 방식이 아닌 팔로워가 pull하는 방식으로 동작하므로, 리더의 부하를 덜어주기 때문이다.
리더에포크와 복구 #
리더에포크는 카프카의 파티션들이 복구 동작을 할 때 메시지의 일관성을 유지하기 위한 용도로 사용된다. (redis의 configEpoch, currentEpoch 같은 느낌이라 생각하면 될듯) 컨트롤러에 의해 관리되는 32비트 숫자로 표기된다. leaderEpoch 정보는 리플리케이션 프로토콜에 의해 전파되고, 새로운 리더가 변경된 후 변경된 리더에 대한 정보는 팔로워에게 전달된다. 리더에포크는 복구 동작시에 하이워터마크를 대체하는 수단으로 활용된다.
리더에포크 사용 x
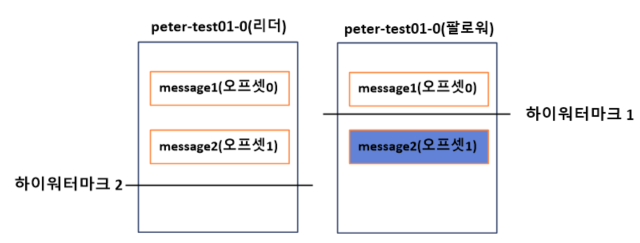
리더 에포크가 없다면 장애 복구 과정은 다음과 같다.
- 리더가 message1을 수신, 0번 오프셋에 저장, 팔로워는 0번 오프셋 가져오기 요청
- 가져오기 요청을 통해 팔로워는 message1을 리더로부터 리플리케이션
- 리더는 하이워터마크를 1로 올림
- 리더는 프로듀서로부터 다음 메시지인 message2를 받은뒤 1번 오프셋에 저장
- 팔로워는 다음 메시지에 대해 리더에게 fetch 응답으로 리더의 하이워터마크 변경을 감지 후 자신의 하이 워터마크를 1로 올림
- 팔로워는 1번 오프셋 message2 메시지를 리플리케이션
- 팔로워는 2번 오프셋에 대한 요청을 리더에게 보내고 요청을 받은 리더는 하이워터마크를 2로 올림.
- 팔로워는 2번 오프셋인 message2 메시지를 리플리케이션했지만 하이워터마크를 2로 올리라는 내용을 전달받지 못함
- 결국 팔로워 다운 ㅠ
장애에서 복구된 팔로워는 카프카 프로세스가 시작되면서 내부적으로 메시지 복구 동작을 한다.
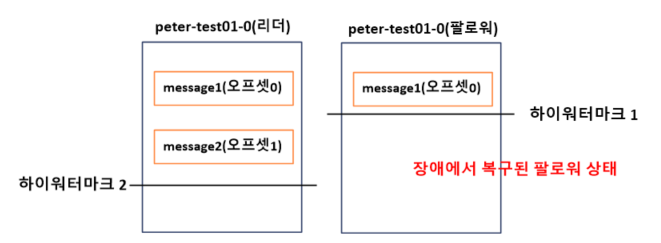
위에는 장애에서 복구된 팔로워 상태다.
- 팔로워는 자신이 갖고 있는 메시지들 중에서 자신의 워터마크보다 높은 메시지를 신뢰할 수 없다고 판단해 삭제한다 따라서 위의 예제에서 message2가 삭제된다.
- 팔로워는 리더에게 1번 오프셋의 새로운 메세지에 대한 가져오기 요청을 보낸다.
- 이 순간 리더였던 브로커가 장애로 다운되면서, 유일한 팔로워가 리더로 승격된다.
결과적으로 message2가 손실이 되었다. (물론 자주 발생하는 케이스가 아니긴하지만.. 그래도)
리더에포크 사용o
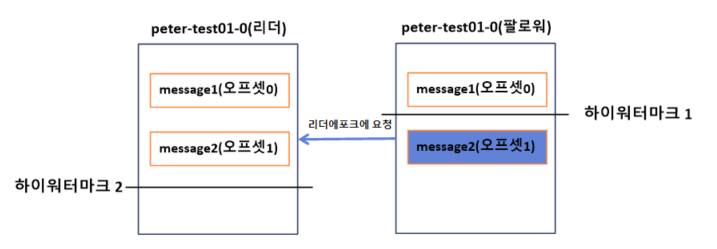
리더에포크를 사용하지 않는 경우에서는 카프카 프로세스가 시작되면서 복구 동작을 통해 자신의 워터마크 보다 높은 메시지를 즉각 삭제했지만 리더에포크를 사용한다면 하이워터마크보다 앞에 있는 메시지를 무조건 삭제하는 것이 아니라 리더에게 리더에포크 요청을 대신 보낸다.
- 팔로워는 복구 동작을 하면서 리더에게 리더에포크 요청을 보낸다.
- 요청을 받은 리더는 리더에포크의 응답으로 1번 오프셋의 message2까지 팔로워에게 보낸다.
- 팔로워는 자신의 하이워터마크보다 높은 1번 오프셋인 message2를 삭제하지 않고, 리더의 응답을 확인 후 message2까지 자신의 하이워터마크를 상향조정한다.
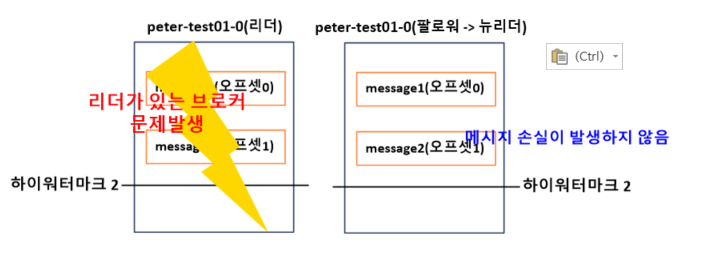
리더에포크 요청과 응답 과정을 통해 팔로워의 하이워터마크를 올릴 수 있고 메시지 손실이 발생하지 않았다!