Kafka Partition
Kafka 파티션은 데이터를 효율적으로 처리하는 데 필수적인 역할을 한다.
각각의 파티션은 독립적인 데이터 스트림을 형성하며, 이를 통해 메시지가 병렬로 처리될 수 있다.
이러한 병렬 처리는 카프카의 성능을 극대화하는 핵심 요인이다.
파티션은 큐를 나눠서 병렬 처리를 가능하게 하는 기본 단위이며, 각 토픽은 하나 이상의 파티션으로 나뉘어져있다.
이를 통해 메시지가 병렬로 처리될 수 있다.
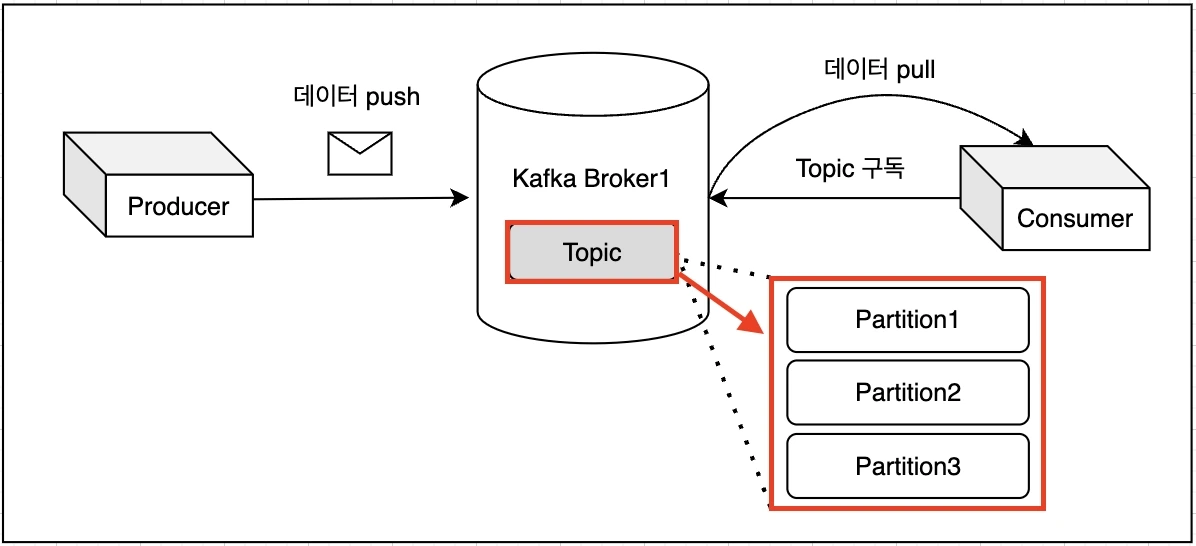
파티션은 순서를 보장하는 로그 구조를 가지고 있다. 이 구조 덕분에 각 메시지는 파티션 내에 고유한 오프셋을 가지게 되고, 이 오프셋을 통해 로그의 위치를 정확하게 식별할 수 있다.
순서를 보장하는 로그 구조 #
카프카의 파티션은 기본적으로 로그 파일처럼 작동한다. 이 로그 구조에서 각 메시지는 순차적으로 저장되며, 각 메시지에는 고유한 오프셋 값이 할당된다. 이 오프셋은 메시지의 위치를 나타내며, 카프카 시스템 내에서 메시지를 정확하게 식별하는 데 사용된다.
파티션의 로그 구조 이해하기 #
- offset 0부터 시작: 카프카에서는 파티션의 각 메시지에 0부터 시작하는 순차적인 오프셋 번호를 할당한다.
- 메시지 추가시 오프셋 증가: 새 메시지가 파티션에 추가될 때마다, 그 메시지는 마지막 메시지의 오프셋에 1을 더한 값이 할당된다. 예를 들어 message a 다음에 b를 저장하면 b에는 오프셋 1이 할당된다.
- 순서 보장: 이 로그 구조 덕분에 파티션 내의 메시지는 항상 순차적으로 저장되며, 각 메시지의 순서는 그 오프셋 값으로 보장된다.
| Offset | Message |
|--------|-------------|
| 0 | Message A |
| 1 | Message B |
| 2 | Message C |
| 3 | Message D |
| 4 | Message E |
순서 보장이 중요한 이유가 무엇일까?
메시지의 순서가 보장되므로, 컨슈머의 데이터는 정확한 순서대로 처리가 가능하다. 이는 시계열 데이터, 트랜잭션 기록 등 순서가 중요한 데이터의 처리에 매우 중요하다. 또한 특정 메시지에 문제가 발생했을 때, 그 메시지의 오프셋을 통해 정확하게 위치를 식별하고 문제를 분석할 수 있다.
파티션의 장점으로는 다양한 컨슈머가 서로 다른 파티션에서 동시에 데이터를 읽을 수 있게 해주는 병렬 처리를 통해서 속도를 크게 향상시킨다는 점과 하나의 파티션 내에서 메시지의 순서가 보장되어, 순차적인 데이터 처리가 필요할 때 유용한 순서 보장, 파티션을 여러 노드에 분산시켜 저장 가능하여 확장성에도 장점을 갖는다.
파티션 복제를 통한 카프카 고가용성 메커니즘 #
카프카의 파티션 복제 개념과 ISR
- 카프카 클러스터는 여러개의 브로커로 구성되어 있다. 이 클러스터 내에서 각 파티션은 하나 이상의 브로커에 복제된다.
- 예를 들어, 하나의 토픽에 대한 파티션 1이 브로커 1의 주 저장소로 있으면, 이 파티션의 복제본은 브로커2, 3에도 존재할 수 있다. 이는 파티션 데이터가 클러스터 내 여러 브로커에 분산되어 저장되어 있음을 의미한다.
파티션 복제와 브로커 내부 복제에 차이점은 무엇일까?
카프카 파티션 복제는 클러스터 내의 다른 브로커들 사이에서 이루어지는 복제를 말한다. 각 브로커는 네트워크를 통해 서로 소통하며, 파티션의 데이터를 복제하고 동기화한다. 반면에, 브로커 내부에서 발생하는 복제는 카파카의 표준 작동 방식이 아니다. 카프카에서는 각 파티션의 복제본을 서로 다른 브로커에 분산하여 저장해야 한다.
결론적으로 카프카의 고가용성은 클러스터 내의 여러 브로커간 파티션 데이터를 복제함으로써 이루어지며, 이는 브로커 내부에서 이루어지는 복제와는 다른 개념이다.
리더와 팔로워
- 리더: 각 파티션에는 한 개의 리더가 존재하며, 모든 읽기 쓰기 연산은 이 리더를 통해 이루어진다.
- 팔로워: 리더를 제외한 나머지 복제본 팔로워로, 이들은 리더의 데이터를 복제해 시스템의 가용성을 높인다. 리더가 다운되면 새로운 리더로 승격될 수 있다.
데이터 손실 방지 및 서비스 연속성
- 만약 한 브로커가 실패하면, 다른 브로커에게 해당 파티션 복제본을 사용해 데이터 손실을 방지하며 서비스의 연속성을 유지한다.
Kafka ISR(In Sync Replica) 을 통해 리더와 동기화 된 상태인 팔로워 집합을 의미한다. 이는 새로운 리더를 승격될 수 있는 팔로워들의 그룹이라고 볼 수 있다.
Kafka 파티션 분산 구조 #
카프카에는 하나의 토픽이 여러 파티션으로 나뉘어 저장된다. 이 파티션들은 클러스터 내의 서로 다른 브로커들이 분산되어 저장될 수 있다. 예를 들어 topic 1이라는 토픽이 있을 때, 이 토픽의 Partition 1은 Broker 1에 Partition2는 Broker 2에 저장될 수 있다.
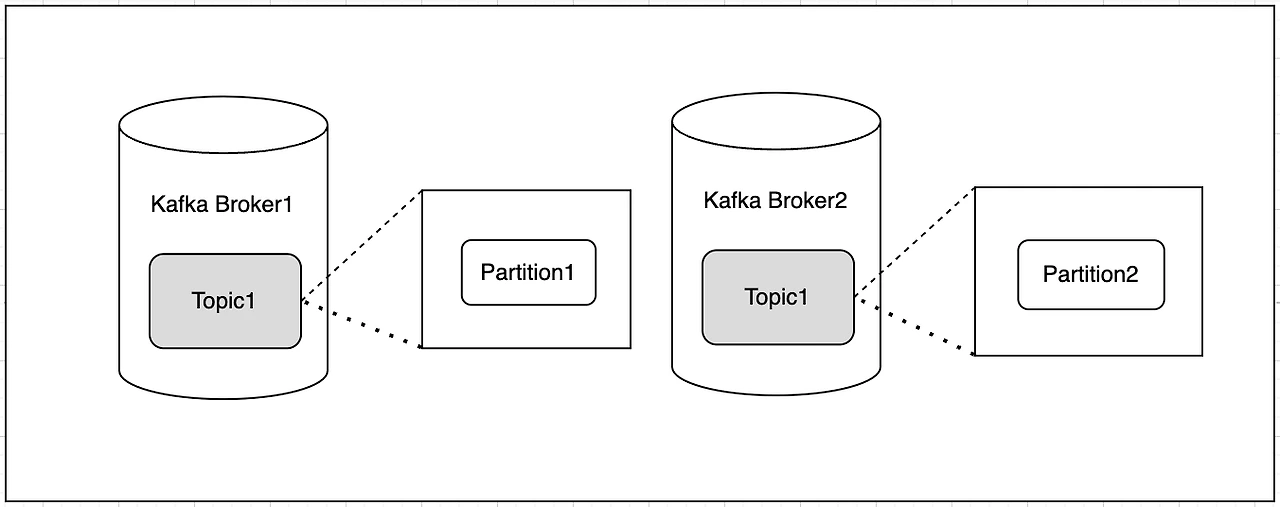
병렬 처리 향상
- 각 브로커가 다른 파티션을 관리함으로써, 여러 컨슈머가 동시에 다른 브로커의 파티션에서 데이터를 읽거나 쓸 수 있다. 이는 전체 시스템의 read/write throught put을 향상시킨다.
- 예를 들어 consumer a는 broker 1의 partition 1에서 데이터를 읽고, 동시에 consumer b는 broker 2의 partition 2에서 데이터를 읽을 수 있다.
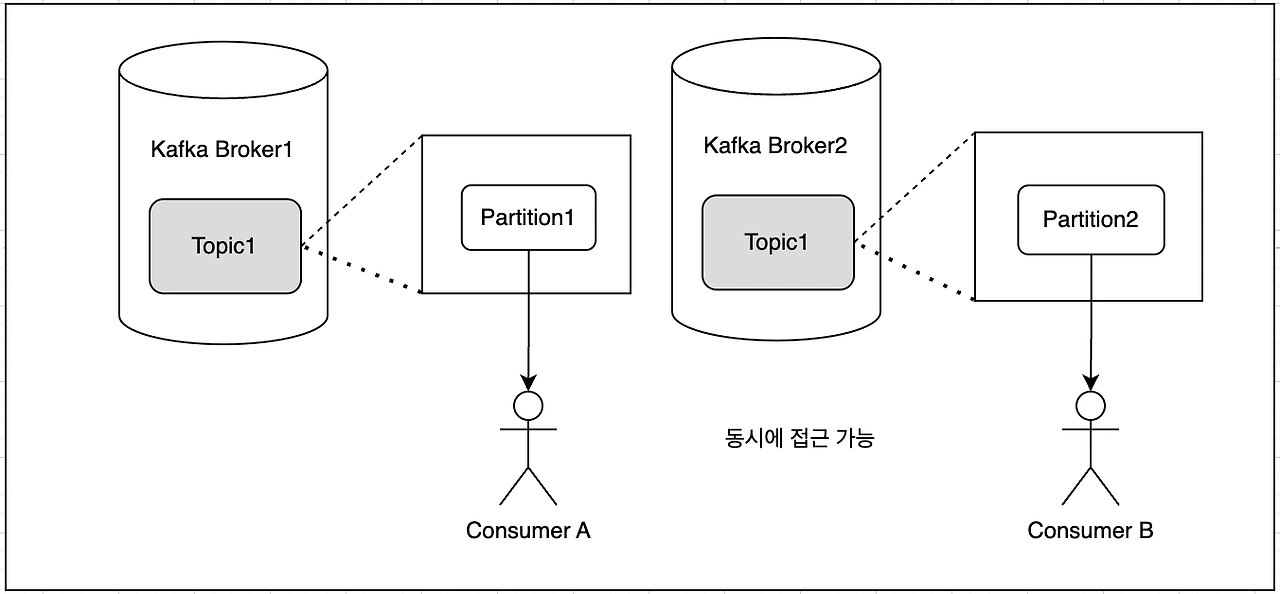
이러한 분산 처리 방식은 카프카 클러스터가 더 많은 데이터를 빠르게 처리할 수 있게 만든다.
각 브로커는 자신의 파티션에서 독립적으로 작업을 수행하기 때문에, 전체 시스템의 부하 분산이 되고 처리 능력이 증가한다.
파티션 내 순서 보장 메커니즘 #
카프카에서 각 파티션은 독립적인 메시지 스트림을 유지한다. 이 스트림 내에서 메시지는 추가되는 순서로 정렬된다.
예를 들어 파티션 1에는 아래와 같이 msg 1 ~ 6, partiton 2에도 독립적으로 1 ~ 6이 도착한다.
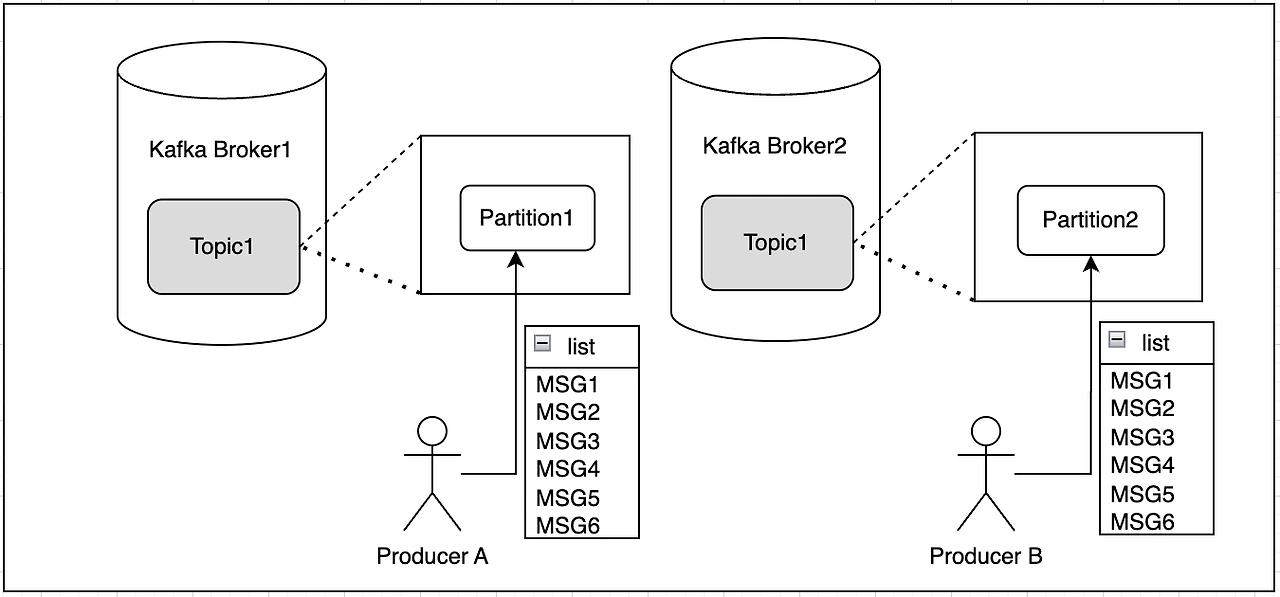
- Partition1: msg1 2 3 4 5 6
- Partiton2: msg1 2 3 4 5 6
위와 같이 순서가 보장되어 메시지가 저장되고 처리된다.
이 예시에서 각 파티션은 메시지가 도착하는 순서대로 저장하고, 이 순서대로 메시지를 처리한다. 이는 카프카의 시계열 데이터나 순서가 중요한 로그 데이터를 처리하는 데 적합하다는 것을 의미한다. 예를 들어 msg1이 거래 시작을 나타내고 msg6이 종료를 나타낸다고 할 때, 카프카는 이러한 이벤트들을 정확한 순서대로 처리하고 저장할 수 있다.
만약 비순차적으로 데이터가 도착했을 때는 어떻게 될까?
예를들어 메시지가 2 5 1 4 5 6 이렇게 도착했다고 가정해보자. 이러면 2가 먼저 처리되고 그 다음에 5 1 순으로 처리될 것이다.
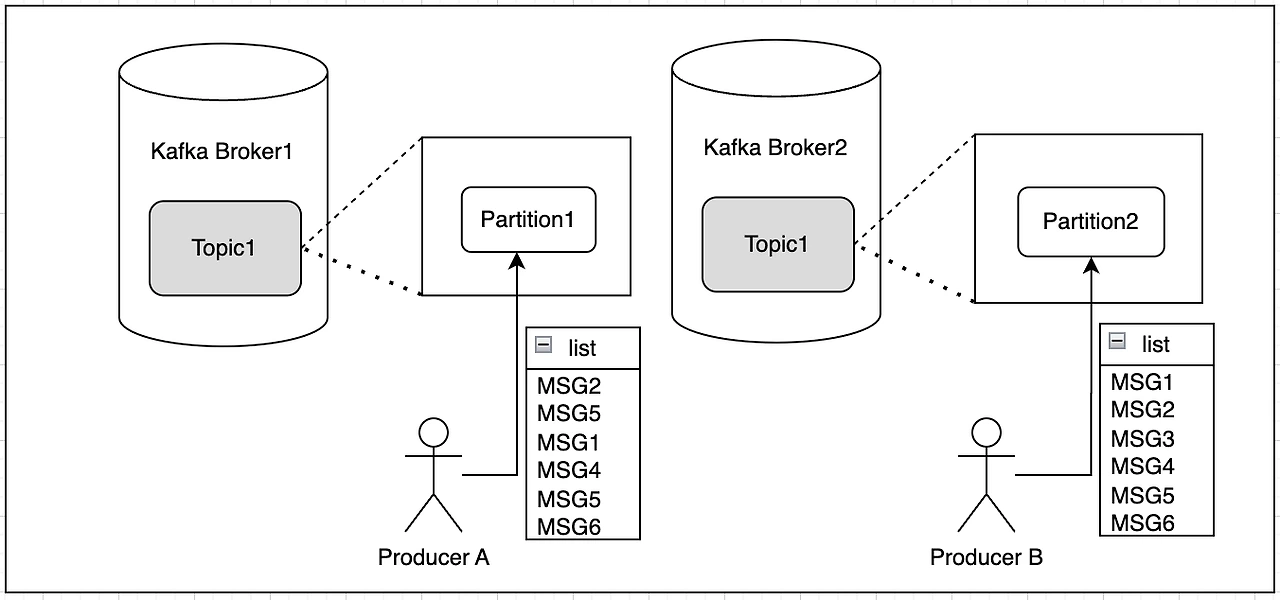
순서 보장의 의미는 메시지가 파티션에 저장된 순서대로 처리된다는 것을 의미한다. 이는 프로더슈가 메시지를 보낸 순서가 중요함을 의미하며 만약 비순차적으로 보내진다면, 그 순서대로 카프카가 처리한다.
따라서 프로듀스 측에서 메시지 발송 순서를 관리하는 것이 중요하다. 특히 시계열 데이터나 트랜잭션 순서가 중요한 경우, 올바른 순서로 메시지를 보내야한다.
결론적으로 Kafka의 파티션에서 메시지 순서 보장은 메시지가 저장된 순서대로 처리된다는 것을 의미한다. 프로듀서가 메시지를 보낸 순서가 파티션 내에서의 처리 순서를 결정한다. 따라서, 메시지가 비순차적으로 보내진 경우, Kafka는 그 순서대로 메시지를 저장하고 처리한다.
카프카 파티션 주의점 #
키 선택의 중요성
- 프로듀서가 데이터를 파티션에 할당할 때 사용하는 키의 선택은 주용하다. 잘못된 키의 선택은 데이터 분산의 불균형을 초래하고, 특정 브로커에 부하를 집중시킬 수 있다.
- 이를 해결하는 방법으로는 키의 해시 분포가 균일하도록 전략을 명확하게 정의하는 것이다.
균형 잡힌 분산
- 카프카 클러스터에서 각 브로커는 하나 이상의 파티션을 관리한다. 이 때 각 파티션에 할당되는 키의 분산이 중요하다. 각 브로커가 관리하는 파티션들이 고르게 할당되는 것은 곧 키의 해시값이 파티션간에 균등하게 분포되어있는 것을 의미한다.
예시 사진은 다음과 같다. 균형잡혀있게 할당되어있는 것을 확인할 수 있다.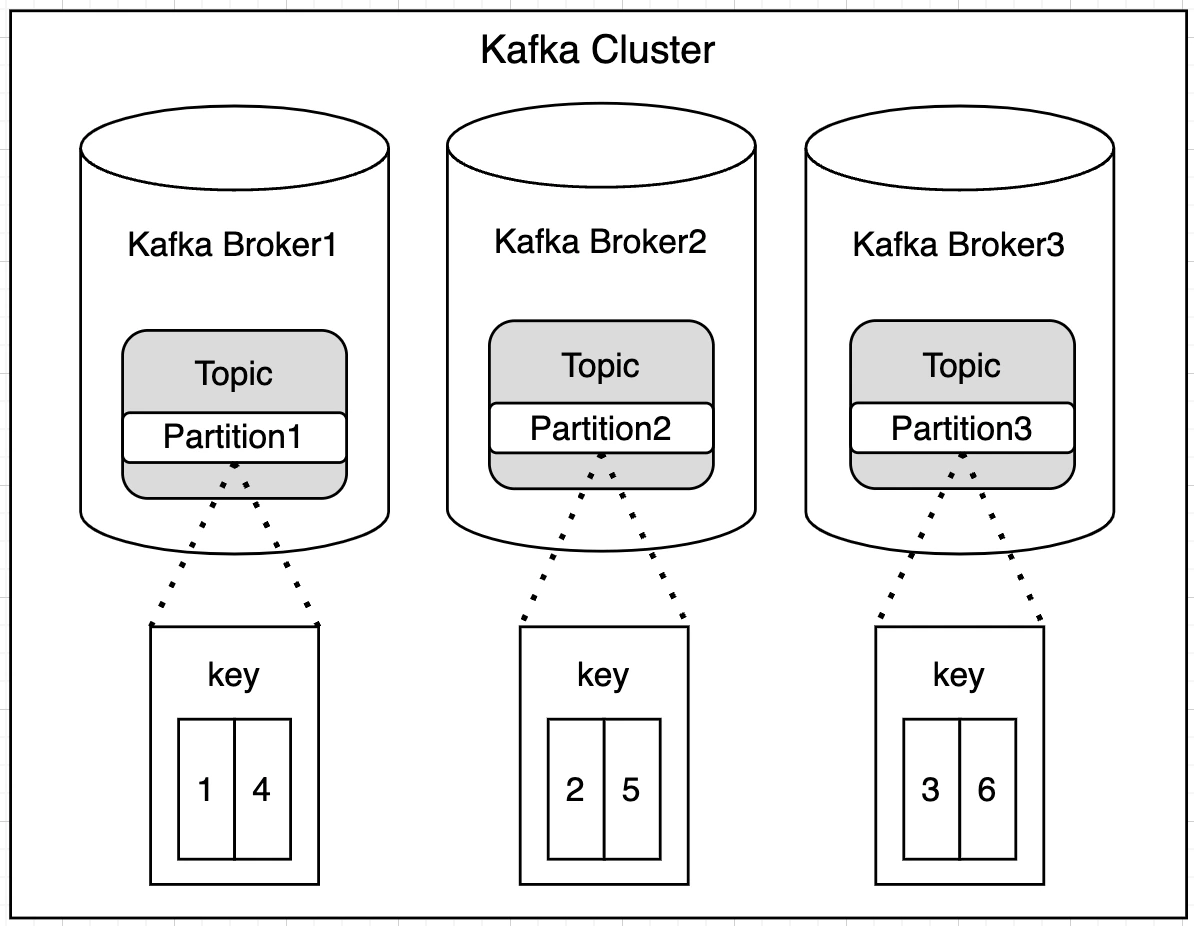
이렇게 되면 각 파티션의 데이터가 균등하게 분산되어 전체 클러스터의 부하가 균형을 이룬다.
결론적으로 클러스터의 모든 브로커가 효율적으로 활용되며, 시스템 전체적인 성능과 안정성이 향상된다.
불균형 분산
- 카프카의 특정 파티션에 키들이 집중되는 경우, 불균형한 분산이 발생한다. 특정 파티션에 키들이 과도하게 집중되어, 다른 파티션은 충분히 활용되지 않아 성능에 문제가 생긴다.
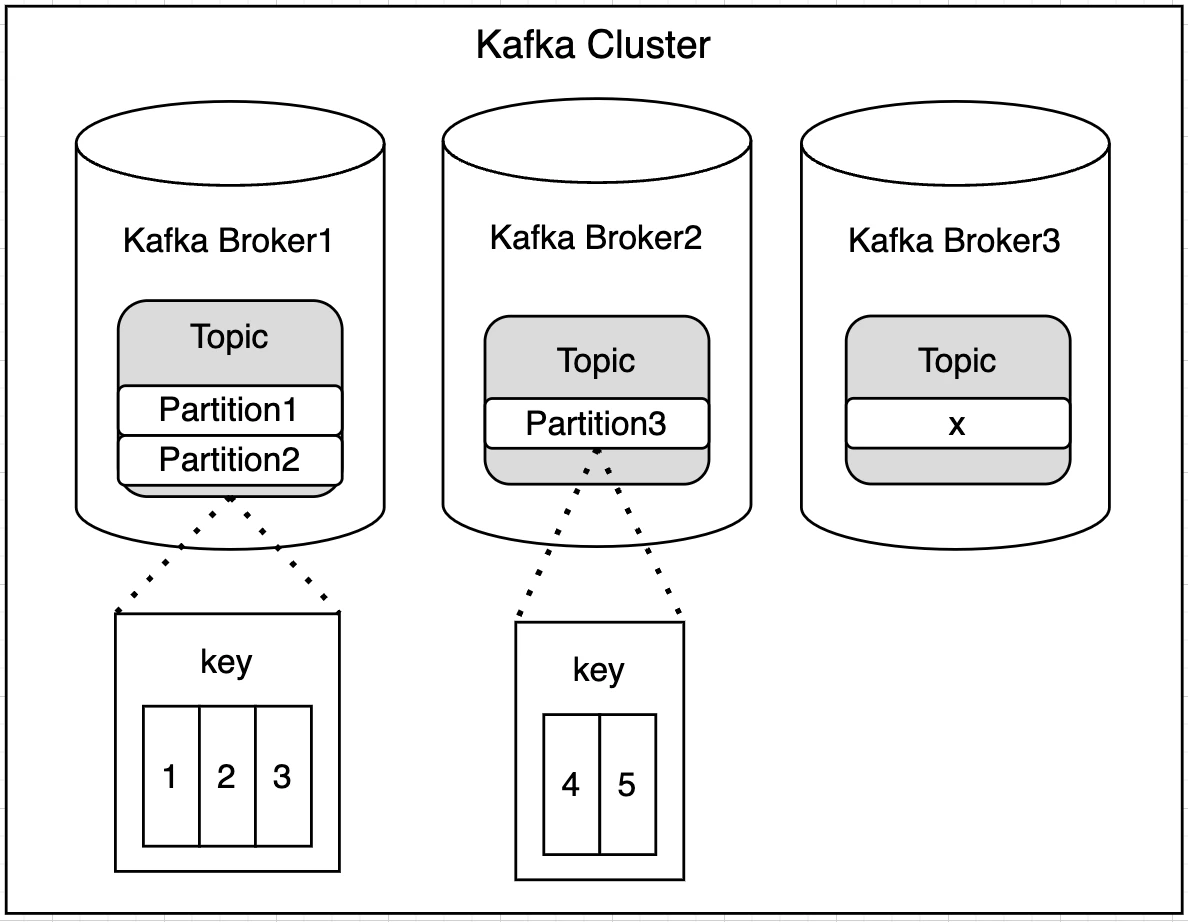
이렇게 카프카에서 키 선택은 전체적인 성능과 안정성에 중대한 영향을 미친다. 균형잡힌 키 분산은 각 파티션과 브로커의 효율적인 활용을 보장하고, 불균형한 분선은 클러스터 성능 저하와 안정성 문제를 야기할 수 있기 때문에 키 분산 전략을 신중하게 고려해야한다.
컨슈머 그룹 관리
- 하나의 컨슈머 그룹 내에서는 컨슈머의 수는 파티션의 수를 초과할 수 없다. 이를 초과하면 일부 컨슈머는 데이터를 처리하지 못해 리소스가 비효율적으로 사요오딜 수 있다. 이를 방지하기 위해서 컨슈머 그룹과 파티션간에 수를 균형있게 맞추는 것이 중요하다.
파티션 재배치의 복잡성
- 파티션의 수를 늘리는 것은 쉽지만, 줄이는 것은 복잡하고 위험할 수 있다. 따라서 초기 설계 단계에서 파티션의 수를 신중하게 결정하는 것도 중요하다.
- 초기에 보수적으로 파티션 수를 설정하고, 시스템이 성장함에따라 조정하는 것이 좋은 접근 방법이다.