분산 환경 합의 알고리즘 Paxos
분산 시스템에서는 여러 대의 서버가 서로 다른 데이터를 가지고 있을 수 있기 때문에 동시성과 일관성을 보장하는 것은 쉬운 문제가 아니다. 이런 문제들을 해결하기 위해서 분산 환경에서 노드 간 합의를 도출하는 알고리즘은 Paxos가 등장하게 되었다.
Introduction #
Paxos 알고리즘은 Leslie Lamport가 제안한 알고리즘으로, 분산된 시스템에서 노드 간 합의를 도출하는 알고리즘 중 가장 널리 사용되는 알고리즘 중 하나다.
Leslie Lamport는 The Part-Time Parilament 라는 논문을 통해 Paxos를 제안했다. 그러나 이 논문 내용은 매우 난해하고 이해하기 어려워, Paxos 알고리즘이 널리 사용되기 까지는 좀 걸렸다.
그 이후 Paxos Made Simple이라는 논문으로 핵심 아이디어와 동작 방식을 쉽게 설명해 이를 통해 널리 사용되게 되었고, 분산 시스템에서 합의를 도출하는 데 필수적인 알고리즘 중 하나가 되었다.
Paxos #
Paxos는 분산환경에서 클러스터의 노드간 합의(consensus)를 도출하는 알고리즘 중 하나다.
해당 알고리즘을 소개하기 앞서 논문에서 활용하는 용어를 먼저 알아보자
- Majority: 클러스터 전체 노드의 절반을 초과하는 수를 의미한다. Majority가 중요한 이유는 Majority 이상의 노드가 동의하는 경우에만 합의가 성립되기 때문이다.
- Message: 노드 간 통신으로 데이터를 주고 받는 데, 이를 메세지라고 표현한다. 메세지는 노드 간에 전달되는 데이터를 말한다.
다음은 Paxos를 정의하는 분산 환경에서의 클러스터 특징이다.
- 클러스터 내의 노드는 언제든 실패할 수 있다.
- 클러스터 내의 노드 역할은 3가지다 Proposer, accepter, learner 하나의 노드는 하나 이상의 역할을 맡을 수 있다.
- 노드의 메시지 처리 속도는 제각각이고, 언제든 실패할 수 있으며 노드는 재시작될 수 있다.
- 각 노드는 디스크 등의 stable storage를 가진다.
- 메시지가 전달되는데 오래 걸릴 수 있으며, 중복되거나 유실될 수 있다. 하지만 메시지 자체가 의도치 않은 방향으로 변경되는 것은 가정하지 않는다.
Paxos를 이해하기 위해서는 Majority를 이해하는 것이 중요하다.
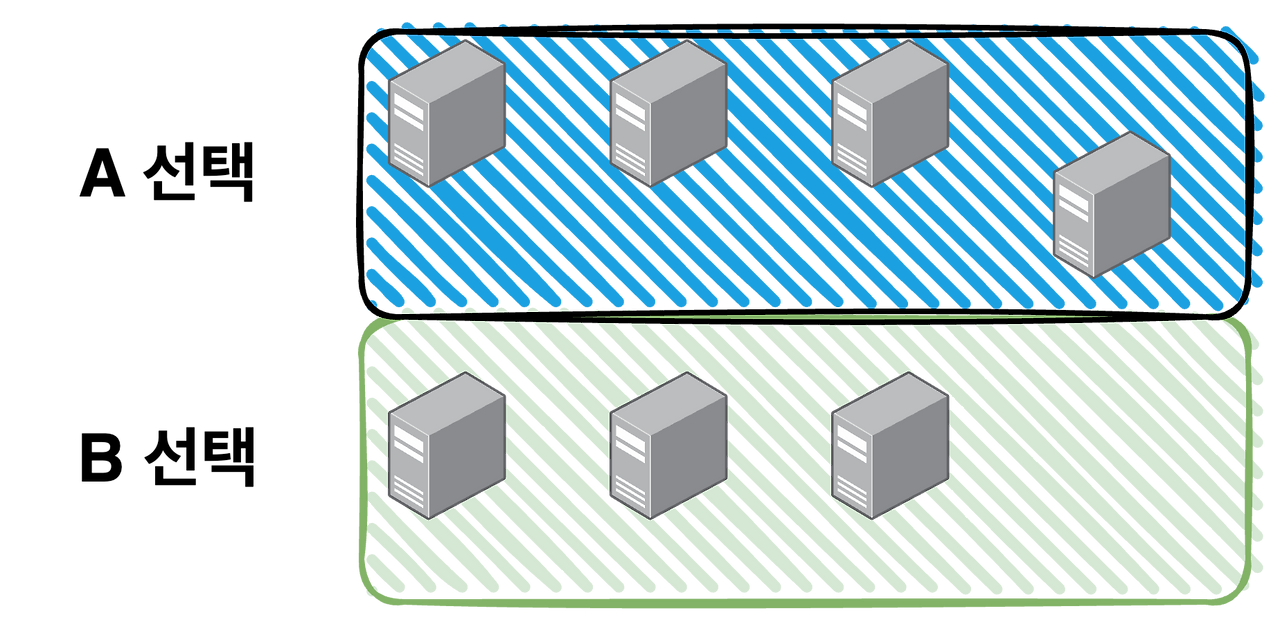
Majority는 클러스터 내 전체 노드 수의 절반을 초과하는 노드 수를 의미한다. Paxos에서는 Majority 이상의 노드가 합의를 도출하면, 해당 값이 클러스터 내 모든 노드가 합의한 것으로 간주된다. 예를 들어, 클러스터 내 전체 노드 수가 7개라고 가정하면, Majority는 4개 이상의 노드를 의미한다. 따라서 4개 이상의 노드가 동의한 경우에만 합의가 도출된다. 만약 Majority 이상의 노드가 특정 값 A에 대해 합의를 도출한다면, 해당 값은 클러스터 내 모든 노드가 합의를 도출한 것으로 간주된다.
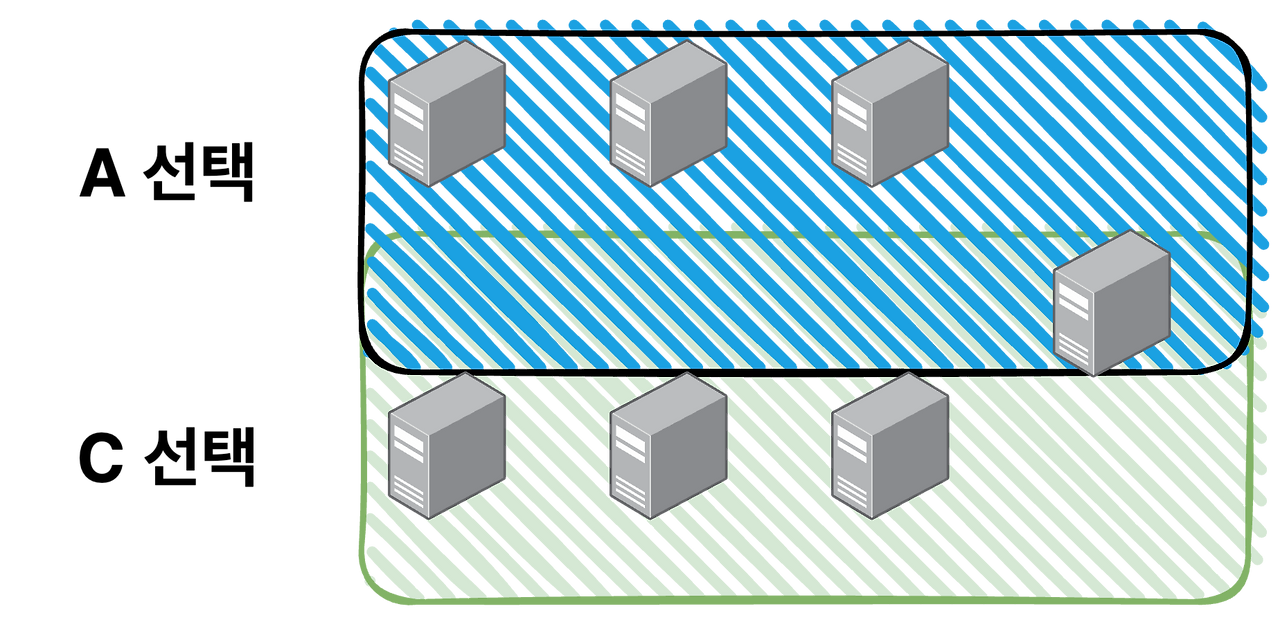
또한 Majority가 A를 선택하는 과정에 있는 경우와 동시에 또 다른 Majority가 C를 선택하는 과정이 있을 수 있다. 이 경우에는 A를 선택한 Majority와 C를 선택한 Majority에 모두 포함된 노드를 통해 최종 합의 값을 결정할 수 있다.
Choosing a Value #
Paxos는 크게 phase 1, 2로 나뉘어져 있다. phase 1은 preare, promise를 그리고 phase 2에서는 accept 메시지를 주고 받는다.
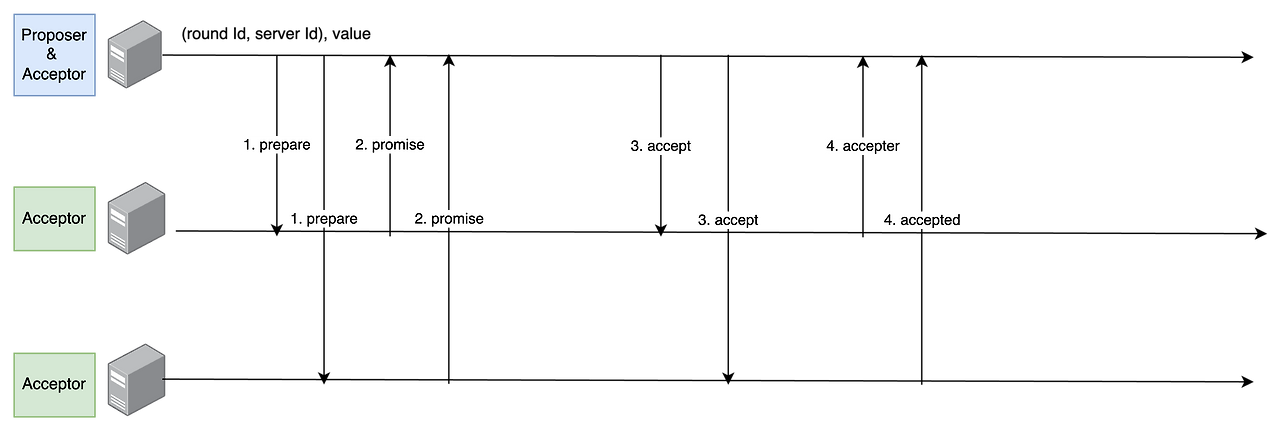
Prepare: proposer은 n대의 accepter 노드에게 prepare 요청을 통해 특정 값을 제안한다. 그 요청들은 다음과 같은 데이터를 포함한다.
- Round ID: 이전 합의 과정에서 사용되지 않은 유일한 값으로 단조 증가하는 값으로 사용할 수 있다. Round ID는 Accepter이 여러 prepare, accept 메시지를 수신하였을 때 어떤 값을 선택할지 결정하는데 활용된다.
- Server ID: 다수의 노드가 동시에 propose를 수행하면, Round ID가 동일할 수 있다. 이를 구분하기 위해 각 서버는 고유한 Server ID 값을 가지고 있다. 이는 각 노드를 고유하게 식별하고, 합의 과정에서 메시지를 구분하기 위한 용도로 사용된다.
- Value: Proposer가 제안하고자 하는 값을 의미한다.
Accepter는 다수의 prepare 요청을 동시에 받은 상태일 수 있다. Accepter는 Prepare 요청 중 round id가 가장 높은 메시지를 선택하고 해당 값을 사용하겠음을 약속하는 promise 응답을 proposer에게 반환한다.
Proposer이 majority 이상의 acceptors로 부터 promise 메시지를 수신하였다면 제안했던 값을 사용하는 accept 메시지를 acceptors에게 송신한다.
Acceptor는 수신된 accept 메시지의 round id보다 높은 round id를 지닌 prepare 요청을 받지 않는 이상 accept 메시지의 값을 사용하기로 합의한다. accepted message response를 통해 합의 과정을 마무리 한다.
Acceptor Failure #
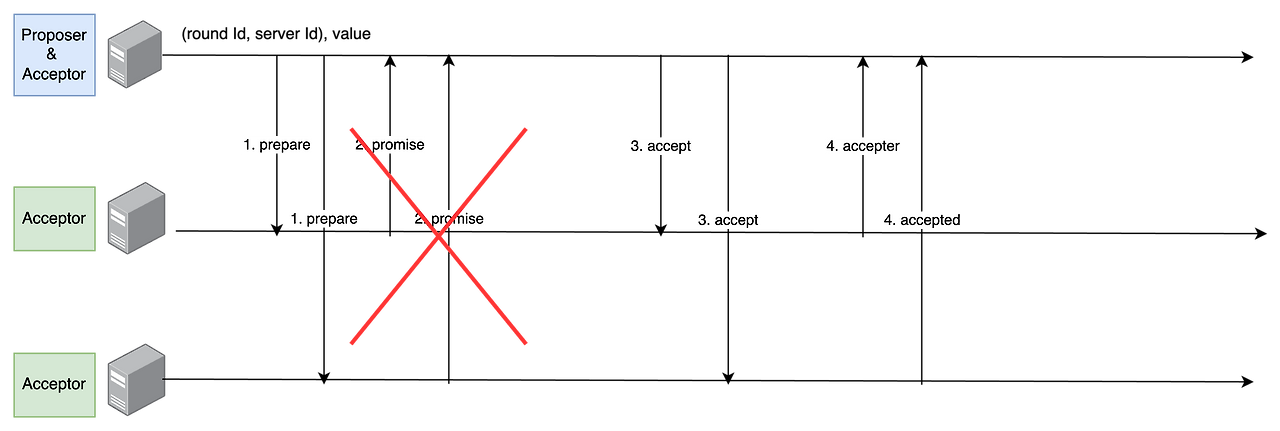
acceptor 노드가 요청을 저리하지 못하는 상황에 대해서 살펴보겠다.
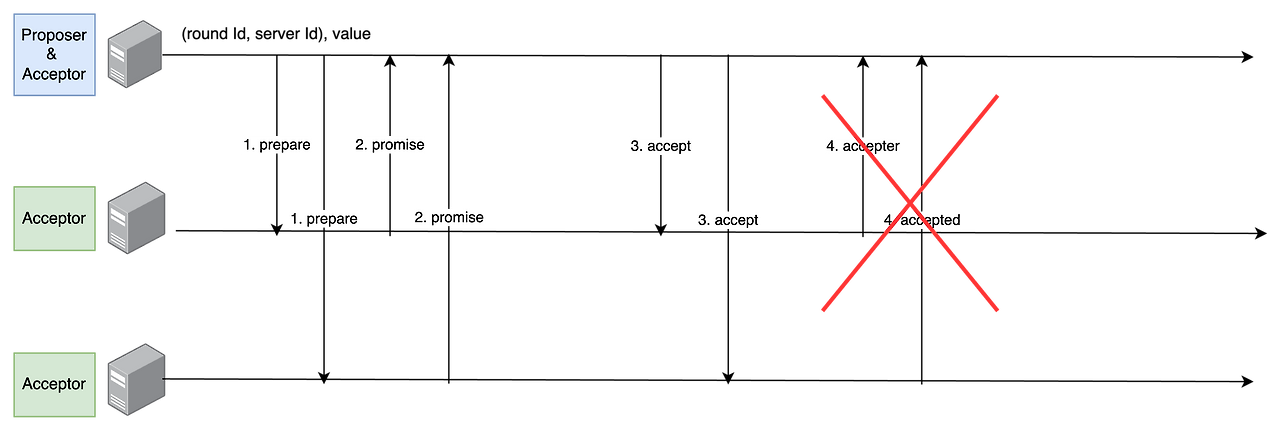
우선 한개의 acceptor만이 실패한 경우를 생각해보자, 이 경우 proposer는 1대의 acceptor로 부터 accepted 메시지를 수신하고, 자기 자신으로부터 accepted 메시지를 수신한 것으로 간주된다. (실제로는 자기 자신과 accepted 메시지를 주고받지 않는다. 하지만 자신이 제안한 값이기 때문에 해당 메시지를 accepted 한 상태로 간주할 수 있다.) 이러한 상황에서 총 3대의 노드를 소유한 클러스터에서 majority 즉 2대 이상이 accepted를 완료했기 때문에 정상적으로 합의 도출이 가능하다.
그러나, 만약 majority 이상의 acceptors가 실패하게 된다면 어떻게 될까? 이 경우 최종적으로 proposer 노드 1대만 accepted 되었기 때문에 majority가 아닌 상황이 되어 합의에 실패하게 된다.
결국 majority 이상의 노드가 동작하면 합의 과정은 정상적으로 수행된다.
promise가 실패하는 과정도 확인해보자
promise 실패 케이스도 위에서 살펴본 accepted 케시으와 유사한데, 만약 majority node가 promise응답을 반환하면 합의 과정은 정상적으로 수행된다.
Proposer Failure #
acceptor가 실패하는 과정을 알아보았다면 이번에는 proposer이 실패하는 과정도 알아보자.
promise 실패
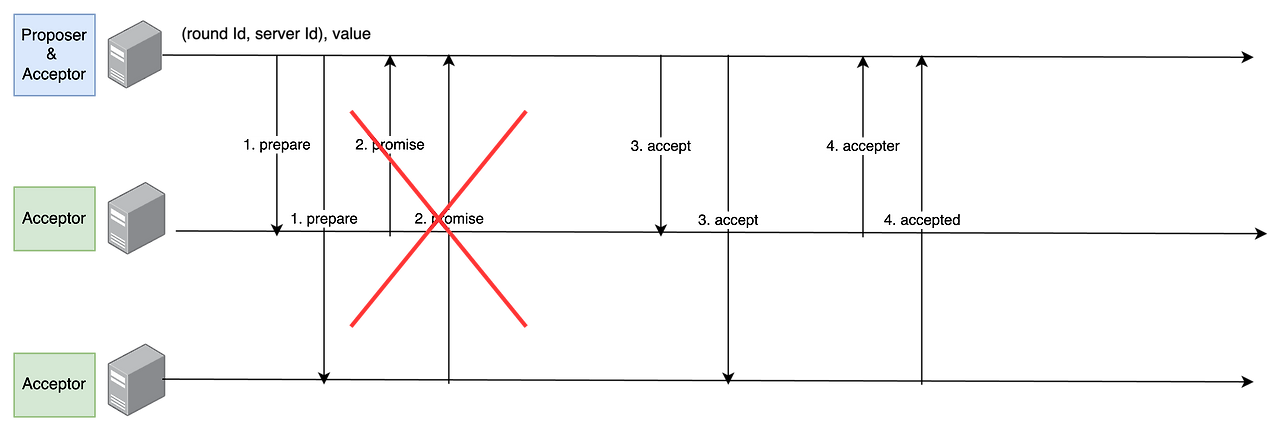
promise 단계에서 proposer이 실패하는 경우 동작하는 노드 중 하나가 proposer로 선출되어 합의 과정을 이어나간다.
accept 실패
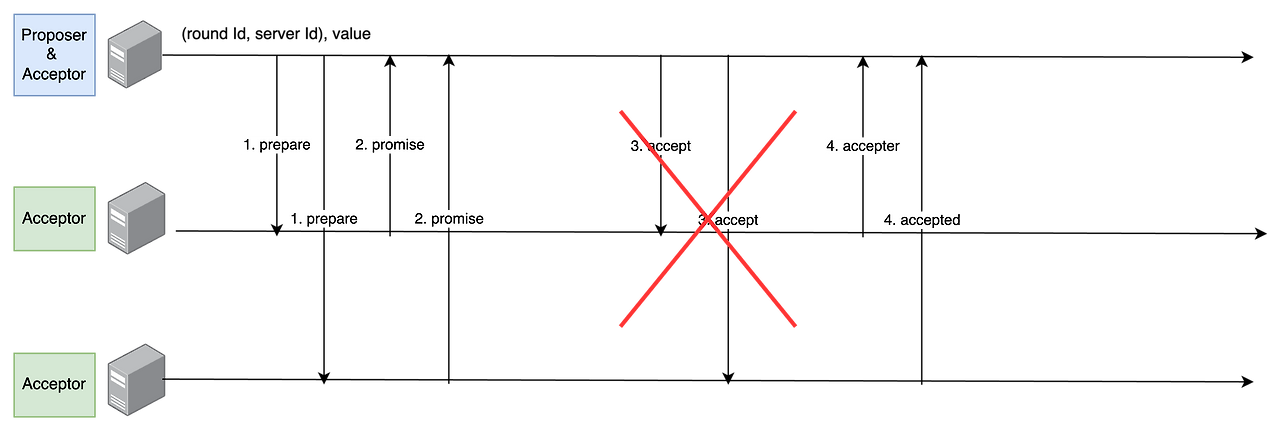
만약 어떠한 accepor도 accept 메시지를 수신하지 못한다면, 합의 과정은 중단된다, 그러나 만약 accept 메시지가 하나 이상의 acceptor에게 전달될 경우 새로운 proposer에 의해 이전의 합의 과정을 이어나갈 수 있다.
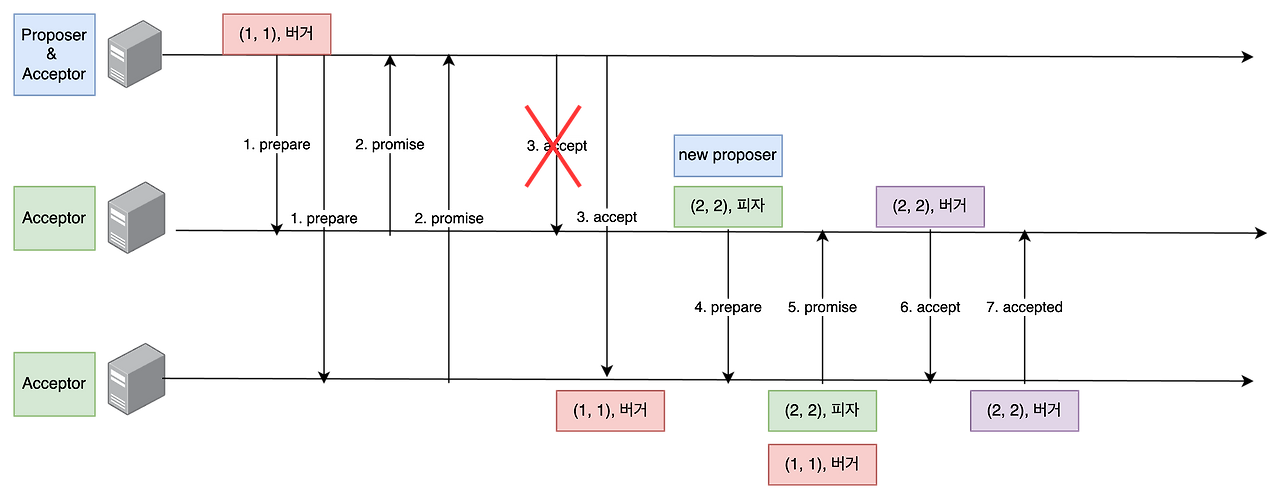
위 그림을 보면 accept 메시지 (1,1) 버거가 하나의 acceptor에만 수신된 것을 확인할 수 있다. 이 acceptor는 다음 prepare 메시지 (2,2) 피자를 수신할 때 이전에 받은 (1,1) 버거를 함께 전달해, 이전 합의 과정에서 이미 선택된 값이 있음을 알린다. 따라서 5번과정에서 promise 응답 메시지를 보낼 때, 이전 합의 과정에서 수신한 accept 메시지의 값을 함께 전달한다. 이전 합의 과정에서 이미 accept 메시지 값이 있으면, 새로운 proposer는 해당 값을 사용해 합의 과정을 이어간다(round id, server id는 새로운 proposer이 지정한 값을 사용한다.)
paxos외에도 raft 알고리즘도 존재하는데 다음 시간에 알아보도록 하겠다.