Data Partitioning
Partitioning #
우리는 데이터를 데이터베이스에 저장한다. 그런데 데이터의 크기가 커지고 복잡해지게 되어 성능에 무리가 간다면 우리는 어떻게 해결할 수 있을까? 바로 데이터를 분산하는 것이다.
데이터를 분산함으로써 우리는 다음과 같은 이점을 얻을 수 있다.
- 데이터베이스 요청 부하 분산
- 확장 가능한 시스템 구축 가능
- 더욱 가까운 데이터센터 활용 가능
- 가용성
파티셔닝 유형 #
범위 기반 파티셔닝 #
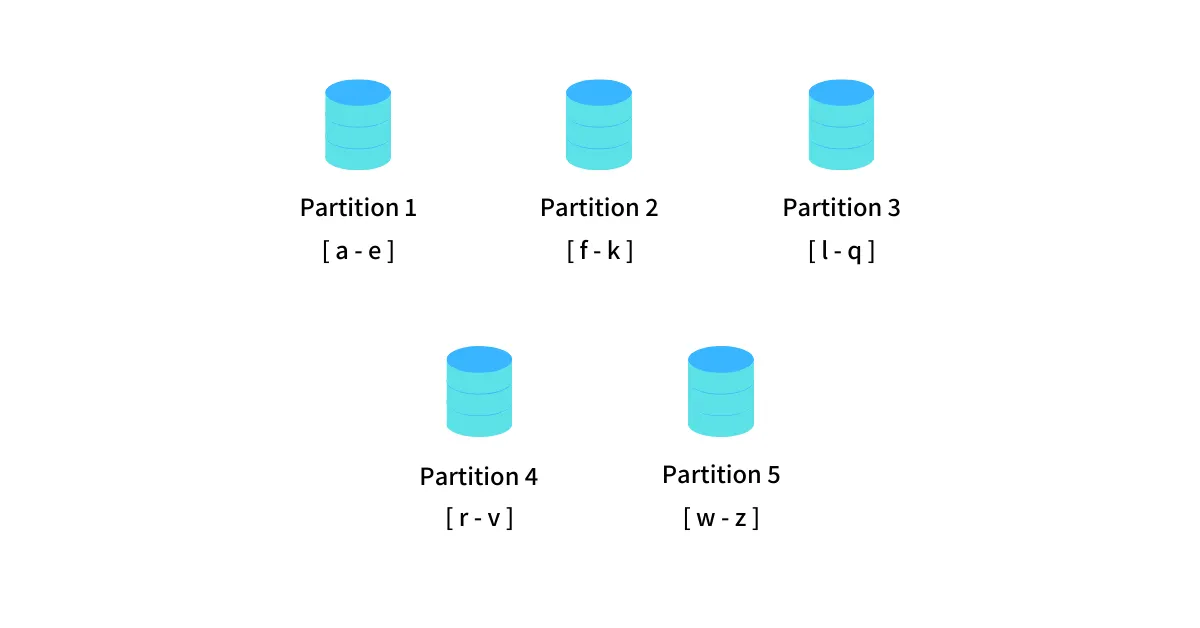
해시 파티셔닝 #
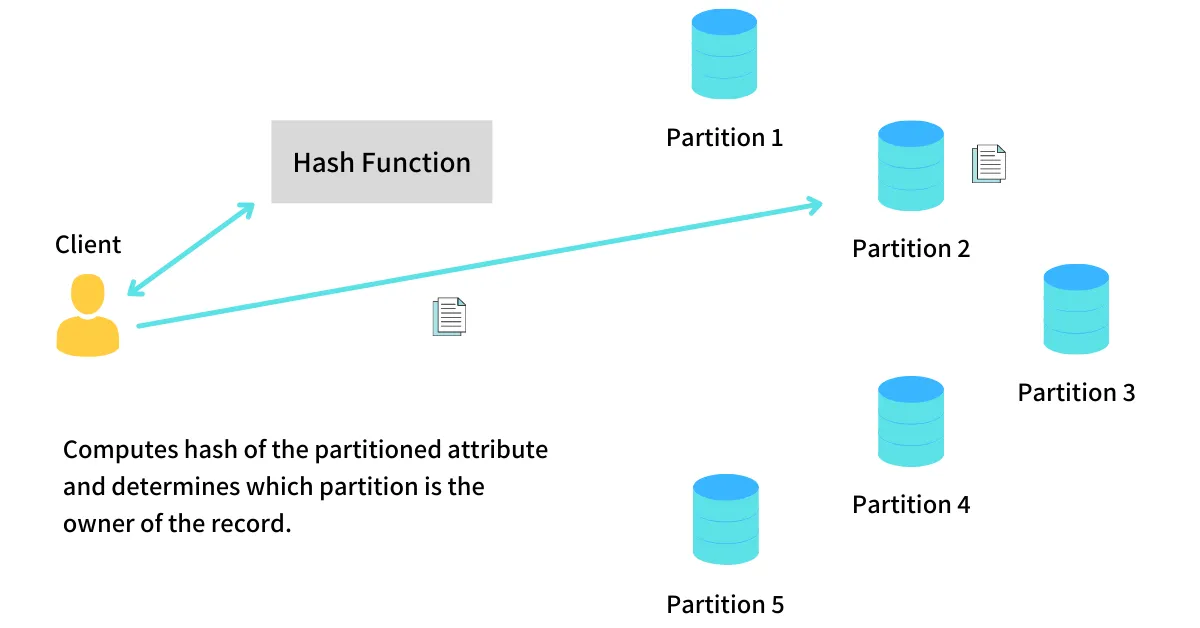
- 리스트 파티셔닝
- 키 파티셔닝
- 라운드 로빈 파티셔닝
리밸런싱 #
쿼리 처리량이 증가해 늘어난 부하를 더욱 처리하기 위해 cpu를 늘리거나 데이터 셋 크기가 증가해 디스크와 램을 추가하고 싶거나 장애 가용성을 위해서 장애를 넘기기 위한 추가 장비가 필요할 때 우리는 노드의 개수를 추가한다. 또한 삭제될때도 결과적으로 데이터가 다른 노드로 적절히 밸런싱되게 움직이는 재균형화가 일어난다.
어던 파티셔닝 방식을 사용하는지에 따라 무관하게 재균형화가 실행될때 보통 만족시킬 것으로 기대되는 최소 요구사항은 다음과 같다.
- 재균형화 후 부하 분산이 노드들 사이에 균등하게 분배되어야 한다.
- 재균형화 도중에도 읽기, 쓰기를 받아들여야 한다.
- 재균형화가 빨리 실행되고 네트워크와 디스크 io 부하를 최소화 할 수 있도록 노드들 사이에 데이터가 필요이상으로 옮겨지면 안된다.
하면 안되는 방법에 대해서 조금 알아보면 해시 값 모드에 n 모듈러 연산을 수행하는 방법이 하면 안되는 방법중에 하나로 예시를 들 수있는데 이는 노드수가 늘어남에 따라 결과가 달라지기 때문에 노드의 추가, 삭제에 따라 데이터가 자주 이동하게 되므로 재균형화 비용이 지나치게 커진다. 데이터를 필요 이상으로 이동하지 않는 방법이 필요하다.
파티션 개수를 고정하자 #
파티션을 노드 개수보다 미리 많이 만들고 각 노드에 파티션을 할당하는 것이다.
이로 인해서 노드가 추가되면 파티션이 다시 균일하게 분배될 때까지 기존 노드에 것들을 뺏어오는 방식으로 동작할 수 있다.
물론 이 방식은 처음 구축할때 파티션 개수가 고정되고 변하지 않으므로 합의점을 찾는 과정이 어렵다.
변동이 심하면 더더욱 찾기 어렵다.
동적 파티셔닝 #
HBase나 리싱크db는 키 범위 파티셔닝을 사용하는 디비에서는 파티션을 동적으로 마든다 즉 파티션 크기가 넘어서면 파티션을 두개로 쪼개 각각에 파티션의 절반 정도의 데이터가 포함되게 한다.
만약 없는 데이터 파티션에 요청이 들어오게 된다면? #
요청 라우팅 #
데이터셋을 여러 장비에서 실행되는 여러 노드에 파티셔닝이 가능한데, 만약 클라이언트에서 요청을 보내려고 할 때 어떤 노드로 접속해야 하는지 어떻게 알 수 있을까?
파티션이 재균형화 되면서 노드에 파티션이 바뀐다. 누군가 foo를 읽거나 쓰려면 어떤 주소로 접속해야 하는건가? 파티션이 재균형화 되면 노드에 할당되는 파티션이 바뀌는데 이건?
service discovery에 일종이다 네트워크를 통해 접속하는 소프트웨어라면 어떤 것이던, 특히 고가용성에서 이중화 설정이 된 상태로 실행하는 것을 지향하는 소프트웨어라면 더더욱 이 문제가 있다.
이런 문제를 해결하기 위해 다양한 방법들이 있다.
- 클라이언트가 아무 노드에나 접속해서 없으면 요청을 올바른 노드에 전달해서 응답을 받고 클라에게 응답을 전달한다. (이는 각 노드들이 서로 노드들에 관한 정보를 알고있어야 전달할 수 있다.)
- 클라이언트의 모든 요청을 라우팅 계층으로 보내 라우팅 계층에서 각 요청을 처리할 노드를 알아내고 전달한다.
- 클라이언트가 파티셔닝 방법과 파티션이 어떤 노드에 할당됐는지 알고있게 한다.
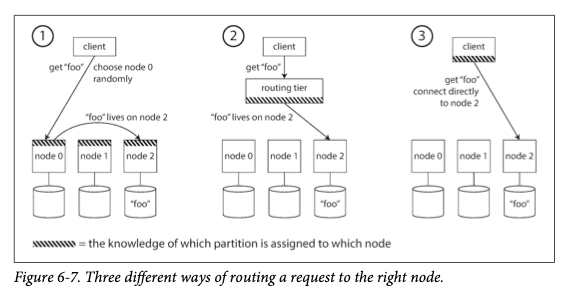
한계가 있는데 이 문제는 참여하는 모든 곳에서 정보가 일치해야 하므로 다루기가 어렵고 그렇지 않으면 요청이 잘못된 노드로 전송되고 제대로 처리되지 못한다.
또한 분산 시스템에서 합의를 이루는 데 쓰이는 프로토콜이 있긴한데 구현하기가 까다롭다.
코디네이션 #
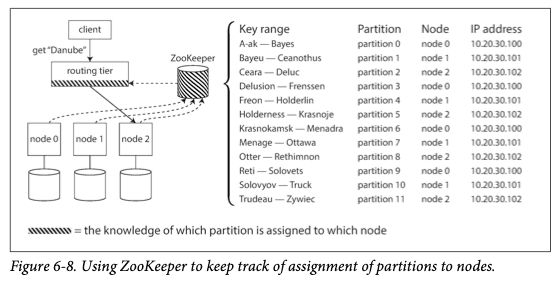
이러한 한계를 극복하기 위해 많은 분산 데이터 시스템은 클러스터 메타데이터 추적을 위해 주키퍼와 같은 별도의 코디네이션 서비스를 사용한다.
각 노드는 주키퍼에 자신을 등록하고 주키퍼 파티션과 노드 사이의 신뢰성 있는 정보를 관리한다.
그래서 파티션 소유자가 바뀌거나 노드가 추가 혹은 삭제되면 주키퍼는 라우팅 계층에게 이를 알려 라우팅 정보를 최신으로 유지한다. 그리고 이 라우팅 계층을 바라보는 다른 구성 요소들은 주키퍼에 있는 정보를 구독한다.
HBase, 솔라 클라우드, 카프카도 파티션 할당을 추적하는데 주키퍼를 사용한다.
몽고디비도 아키텍처는 비슷한데 자체적인 config server에 의존하고 mongos라는 데몬을 라우팅 계층으로 사용한다.
카산드라와 리악, 레디스는 다른 방법을 쓰는데 gossip protocol이라는 클러스터 상태 변화를 노드 사이에 퍼트린다. 아무 노드나 요청을 받을 수 있는 Full mesh 구조고 요청을 받은 노드는 요청을 처리할 파티션을 갖고 있는 올바른 요청 노드로 전달해준다.