Parallel GC Hang Alert
내가 관리하던 배치시스템에서 full gc hang이 걸려 안그래도 무거운 테스크가 무한대로 돌던적이 있었다.
보통 3~4시간이면 끝나는 결산 테스크였는데, 주말에 8시간이 지나도 아무 알림이 없었던 것이였다. 끝났다는.
혹시나 하고 보니 oom은 나지 않았고 로그를 봤을대 20퍼센트정도의 데이터를 처리해놓았었다. 그리고 2시간이 지나고 다시확인해보니 21퍼센트를 처리하고있었고, 그러다 oom이 결국 났다.
배치 시스템의 gc는 parallel gc였고, 최근에 성장세가 높아 처리해야할 데이터가 많아졌다는사실은 알고있었다.
일단 여기서 내가 이상한걸 감지했던것은 왜 OOM이 빨리 안났을까와 + jstat으로 gc로그를 봐서 full gc hang이 걸려있는걸 확인했고 이를 감지할 수 있는 시스템이 있었다면 주말시간을 이렇게 박아넣지 않아도 괜찮았을텐데 라는 생각을 했었다.
가시성 #
일단 batch system에 jvm level observability가 필요했다 open jdk 8기반 pure java batch system이라 spring boot actuator에서 제공해주는 /metric는 쓸수없었다.
그렇지만 JMX Prometheus Exporter라는 별도의 jar파일을 다른 포트에 띄워 도커파일에 같이 말아 올리게 되면, 같은 컨테이너 다른 포트에 jmx metric을 수집해주는 prometheus exporter를 띄워둘수있다.
java -jar -javaagent:./jmx_prometheus_javaagent.jar=9404:./config.yaml savings-bank-api.jar
9404로 듸워두고 jmx_prometheus_javaagent를 initContainer job에 추가해두고 처리하면 바로 같이 띄울수가 있다.
initContainers:
- name: jmx-agent-downloader
  image: curlimages/curl:8.6.0
  command:
    - sh
    - -c
    - |
      echo "[Init] Downloading jmx_prometheus_javaagent.jar..."
      mkdir -p /opt/jmx && \
      curl -fSL -o /opt/jmx/jmx_prometheus_javaagent.jar \
      https://repo1.maven.org/maven2/io/prometheus/jmx/jmx_prometheus_javaagent/0.20.0/jmx_prometheus_javaagent-0.20.0.jar && \
      ls -lh /opt/jmx && \
      echo "[Init] Done."
  volumeMounts:
    - name: jmx-exporter-volume
      mountPath: /opt/jmx
볼륨 마운트해두고 다음과같이 jar를 내려받아서 같이 띄워주면 된다. 물론 프로메테우스가 수집할 수 있도록 포트도 열어두자.
Full GC Hang #
일단 JMX Exporter를 쓴다면 아래 두 가지 메트릭이 핵심이다.
jvm_gc_collection_seconds_sum: GC에 소요된 누적 시간 (가장 중요함)jvm_gc_collection_seconds_count: GC 발생 횟수.
이때 Minor GC가 아니라 Major(Full) GC만 필터링 해야한다.
- Parallel GC:
gc="PS MarkSweep" - G1GC:
gc="G1 Old generation"
자 이제 어떤 메트릭을 쓸지는 알았고 이제 어떤 기준으로 Hang을 판단했는지를 고민해야한다.
우리 시나리오로 예를 들면, 지난 1분동안 GC하느라 예를들어 10초이상 썼는가. (GC Overhead)
시스템이 완전히 멈추지는 않았지만, cpu가 대부분 gc를 점유하고 있는 GC Thrashing 상태를 감지해야한다.
increase(jvm_gc_collection_seconds_sum{gc="PS MarkSweep"}[1m]) > 10
지난 1분동안 10초이상 청소하는데 썼다를 의미하고 16%이상의 cpu 손실을 의미한다. 그리고 월결산 배치기 때문에, 이정도는 너무 짧고 30초 50%정도가 gc를 먹고있다면 gc hang으로 판단하기로 결정했다.
새벽 2시에 도는 배치고 4시간안에 끝나더라도 사실상 주말이면 24시간 안에만 끝내면 되는거고, 50%정도까지 gc쓰는건뭐 우선순위가 더 낮긴했다.
단발성으로 Full GC가 길었던 시간은 중요하지 않다. 이건 배치성 작업이라 성격이 각각의 고객이 늦은 응답을 받아 P99가 박살나는걸 해결하기 위한 목표가 아니였기 때문에 이는 고려하지 않았다.
예외 상황
그리고 추가적으로 하나 더 있는데 JMX Prometheus Exporter에서 metric을 가져오는지라 Full GC의 영향을 JMX Exporter도 받을수도 있다. Full GC가 너무 심각해서 prometheus가 수집하러 갔는데 타임아웃이 나서 데이터를 못가져올수도있다.
그래서 이런 메트릭이 끊기는 현상도 감지해줘야한다.
scrape_duration_seconds{job="my-batch-job"} > 5
AlertManager #
알림 시스템은 이 지표를 기반으로 AlertManager를 통해 구현한다.
prometheus_rules.yaml
groups:
- name: BatchJobAlerts
  rules:
  - alert: FullGCHangDetected
    # Full GC 시간이 1분간 20초 이상일때
    expr: |
      increase(jvm_gc_collection_seconds_sum{gc="PS MarkSweep"}[1m]) > 20
    for: 1m  # 이 상태가 1분간 지속되면 알림 발송
    labels:
      severity: critical
    annotations:
      summary: "배치 서버 Full GC Hang 감지 (Instance {{ $labels.instance }})"
      description: "현재 Full GC로 인해 시스템이 멈춰있습니다. 힙덤프 확보가 필요할 수 있습니다."
이렇게 해서 GC의 Hang을 감지해볼수가 있다.
그 이후 대처 #
그리고 나서 몇가지 이유를 살펴보았다. 일단 관측성이 없던 배치 시스템에 문제는 해결했으나 그 문제까지 포함하자면 현재 배치시스템에는 다음과 같은 문제들이 있었다.
- 관측성 부족
- Full GC Hang
- OOME
일단 감지는 했지만 해결을 못한 Full GC Hang에 대해서 알아봐야하고 JVM Level에서의 OOM이 아니라 Kernel Level의 OOM Killer가 돌아서 덤프도 남지 않는 문제도 있었다(심지어 덤프 남기는 옵션도 없었음)
일단 Full GC Hang이 난 이유는 간단했다. 해당 결산 배치 테스크가 사용하는 데이터를 단순하게 전부 get해서 메모리에 올려둬 aggregate하는 dto로 매핑한후 data lake에 insert upload하는 방식으로 돌았는데, 이때 올려둔 메모리에 데이터가 많아서 발생한 것이다.
애매하게 OOM이 나지 않고 FullGC가 걸리고 OOM안나고 또 FullGC가 돌고.. 그런식으로
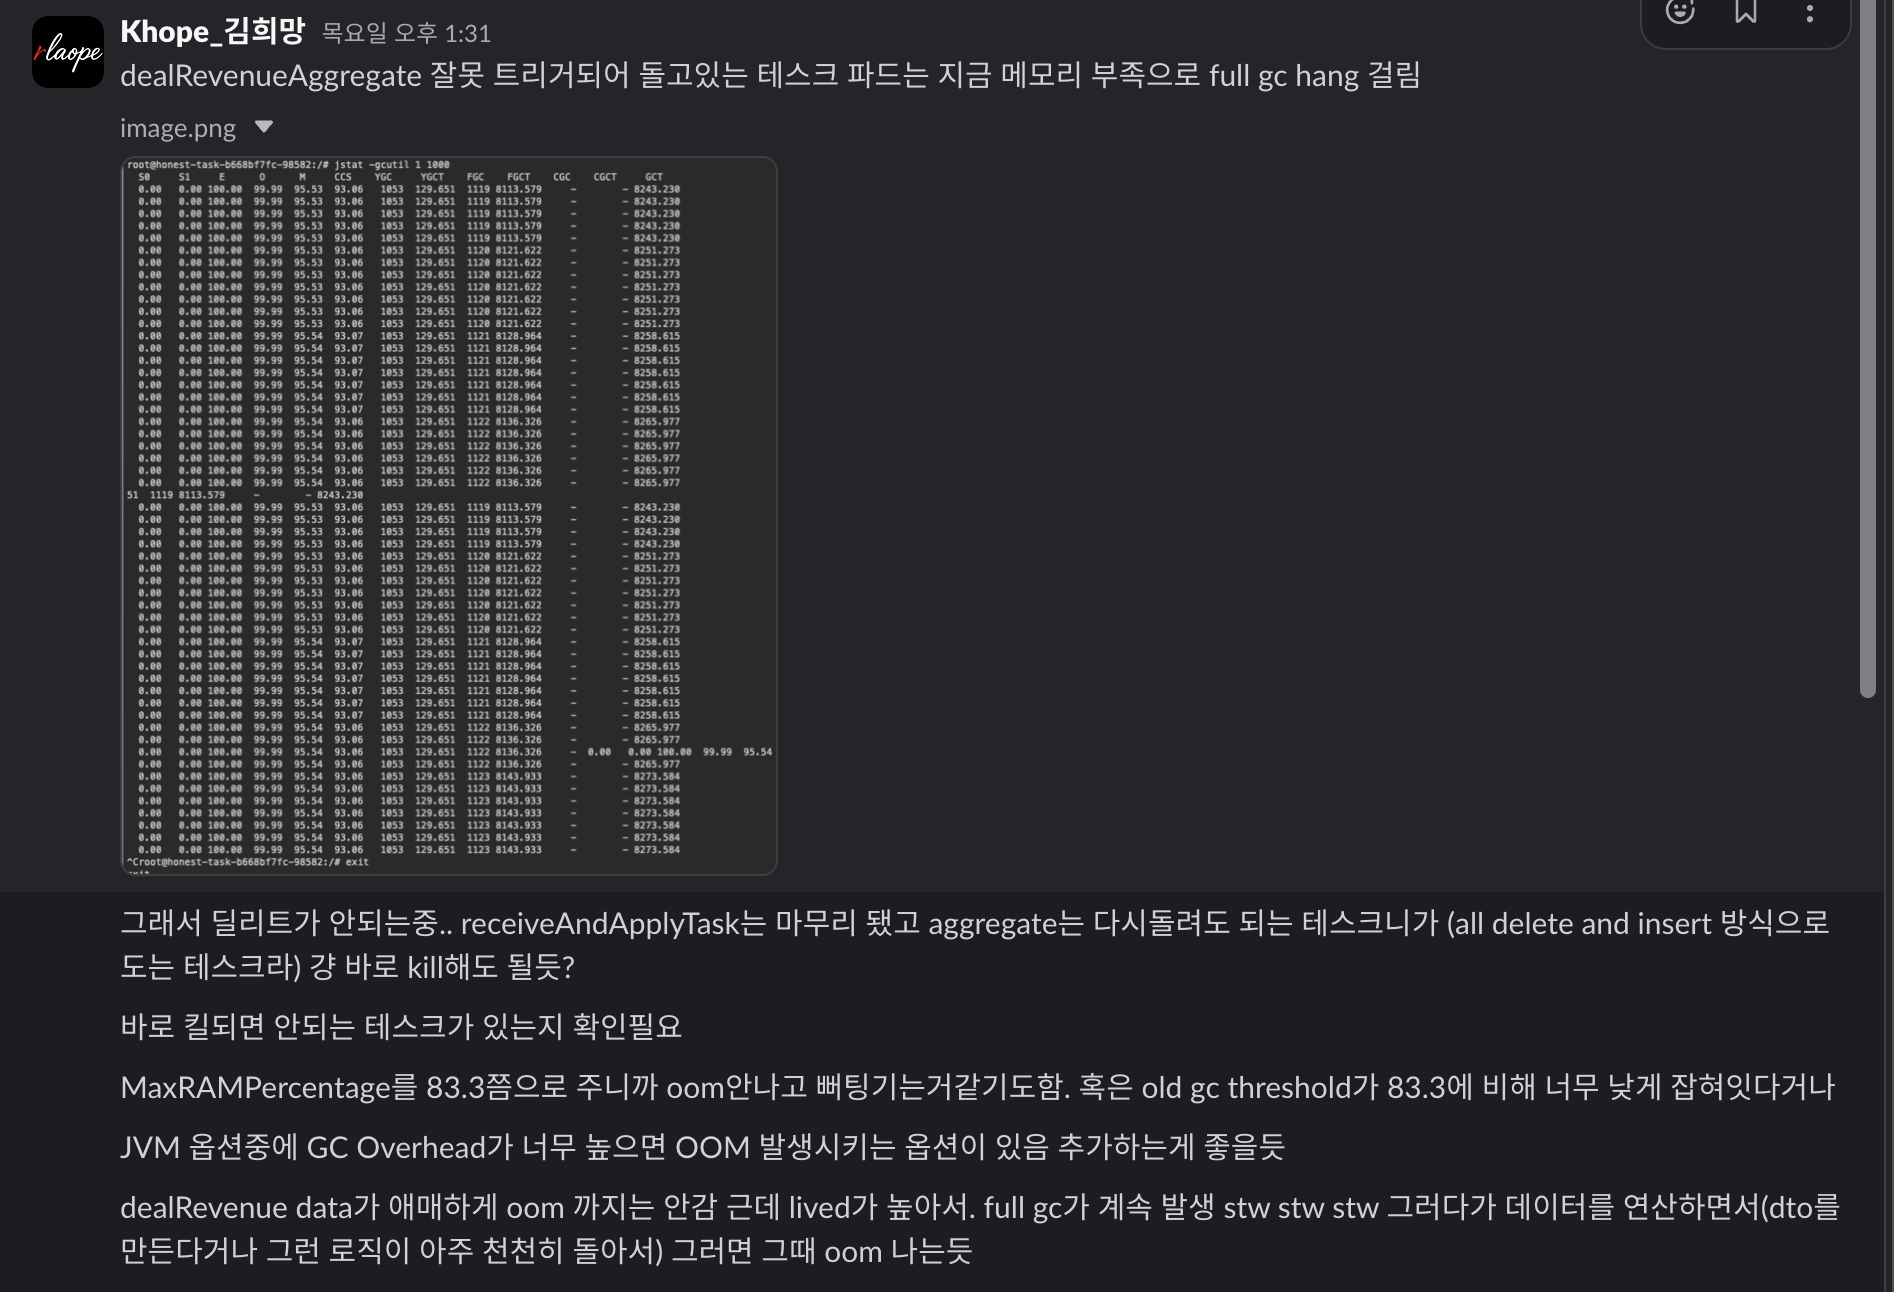
살펴보니까 일단 Full GC의 시간이 일정 시간 이후에(3시간 이후부터) 90퍼센트 이상이 stw로 걸려있었다.
그래서 데이터를 aggregate하는 로직에서 1 2건씩만 돌고 또 stw당하고 근데 메모리에 데이터들 다 살아있고..
Heap Size가 부족한건 당연히 맞았지만 OOM이 바로 발생하지 않은것은 또 별개의 문제라고 생각했다.
확인해보니 MaxRAMPercentage가 83.3% 설정되어 있었다.
과거에 테스크 서버다보니 힙사이즈를 많이 준다는 의사결정이였던거같다. 기본적으로 jvm이 oom을 발생시킬때
gc의 overhead를 감지해서 발생시키는 옵션인 GCOverheadLimit가 존재한다 디폴트로 활성화되어있고 (gc 시간 비율 >= 98%)가 있는데 운이 안좋겠도
여기에 걸리기보다 MaxRAMPercentage에서 줘버린 힙의 양때문에 OOME가 먼저 발생해버린것이다.
JVM의 메모리영역은 힙뿐만 아니라 native memroy, metaspace, code cache, thread stack등 다양하게 존재하기도 한다. 그래서 사실 힙사이즈가 부족할거같다라는 문제에 대해서는 힙사이즈를 늘리는게 맞지 않았을까 생각이된다. 8GB를 갖고있었는데, 일단은 16GB로 늘려서 그날 테스크는 마무리 시켰다.
Heap size 튜닝 #
일단 8GB를 단순하게 늘려주기 이전에, MaxRAMPercentage는 60%로 낮추어주었다 디폴트는 50인데 테스크 서버니까 60으로 두었다. 이러면 코드 캐시나 네이티브 메모리 영역에도 여유가 생겨 최적화레벨을 더 높여볼수도 있지않을까라는 뇌피셜이 있긴하지만 anyway
일단 결과적으로 메모리에 전부 데이터들을 올려서 처리하는 것 자체가 문제였다고 생각한다.
이 월결산 테스크가 어떤 구조냐면 aggregate 데이터를 insert하는 테스크인데, aggregate할 target이 하나가 아니다. (대출자, 투자자, 수수료, 등등등) 데이터들이 많이 있고 각각의 테스크들이 분리되어있고 필요할때 트리거해서 뽑을수있는 기능이다.
근데 월말마다 이런 회계데이터는 필수로 요구된다 그래서 각각의 테스크 코드들을 또 하나로 모은 코드가 바로 이 테스크인것이다.
물론 모든 target 데이터들을 메모리에 올리지는 않는다. 각각의 target 데이터들 모두를 메모리에 올린다. 일단 간단하게 chunk방식으로 올려서 insert하게 해놨다. 별도의 update방식은 존재하지 않으며
데이터 검증하는 task도 존재하고 확인할 수 있으며, 애초에 이 회계데이터를 또 다른 경영팀에서 크로스체크를 하기 때문에 그때 보정작업을 처리하기도 한다.
결론 #
- jmx prometheus exporter로 jvm observability 개선
- alert manager로 full gc hang 감지
- full gc hang걸린 테스크 코드 개선 및 heap 튜닝으로 oome 방지
얻은것은 관측성(메트릭, 알람, heapdump)과 oome 방지, 그리고 task 서버 최적화와 부담스러운 결산작업에 대한 비용이다.