G1GC, ZGC 성능 비교 테스트
zgc: http://github.com/esperar/estudy/blob/master/Back-End/JAVA/zgc.md
시나리오 #
목적은 g1gc, zgc 비교 테스트
- 인스턴스: c7g.2xlarge(8 vCPU, 16BiB) 인스턴스 기준점
- jdk 21 (GenZGC 사용가능)
- 300
800RPS 요청/응답 (15ms 급 로직 + 직렬화) - 할당률을 2개 케이스로 분리함
- A: 중간 할당 (예: 5~10GB/s 미만 수준)
- B: 매우 높은 할당 (예: 코어 다 쓰면서 20~30GB/s 급)
이렇게 나누는 이유는 zgc가 p999같은 tail latency를 줄이는 대신 할당률이 극단적으로 높아지면 throughput 측면에서 g1이 유리해지는 경우가 실제 관찰된다.
GenZGC는 기존 세대 개념 young old를 도입한 gc로 짧은 puase라는 zgc 목표는 유지하면서 단명 객체 young 영역을 빠르게 수거해 cpu를 개선한 버전 zgc는 낮은 지연시간에 초점을둬 cpu 효율이 희생되는 경우가 잇음, old new 객체가 공존하고 읽을때 read barrier를 통해 cpu사용률이 높아짐 그래서 세대 gc 개념을 결합해 빨리 단명하는 객체는 빨리 수집해 최적화 시킨 버전임.
해당 지표들을 뽑을거임
- Latency: p50/p95/p99/p999, max
- Throughput: RPS/TPS, error rate
- GC: pause histogram, concurrent time, allocation rate, gc cause
- 시스템: CPU%, RSS, context switch, run queue
- JVM: safepoint time(중요), heap usage, native memory
시뮬레이션 예시 결과 #
CaseA 중간할당률 (일반적인 고트래픽 api)
가정: heap 8gb, live set 35g, rps는 cpu 7085%까지 밀어붙힘
- G1GC
- Throughput(RPS): 기준 100%
- 응답지연: avg 8ms / p99 35ms / p999 180ms
- GC Pause: p99 25ms / max 300~800ms (가끔 긴 퍼즈가 tail튐)
- cpu 70~85%
- RSS(프로세스 메모리): heap + native 합 상대적으로 낮음
- ZGC (GenZGC)
- Throughtput(RPS): G1대비 -0~10% (환경따라 역전가능)
- 응답지연: avg 9ms / p99 20ms / p999 60ms
- GC pause: 대부분 한 자릿수 ~ 10ms 근처로 제한
- CPU: G1 대비 +5 ~ 15% (read barrier/동시 작업 비용)
- RSS: G1 대비 증가 경향 (메타데이터/동시 이동 여유분)
- GenZGC는 특히 native footprint가 늘 수 있다는 언급이 있음.
요약하면 case A에서는 ZGC p999가 확 줄었고 끊김을 줄이는 대신 cpu mem을 조금 더 씀.
지연시간은 zgc 승, 메모리 cpu 사용률은 g1gc 승
CaseB 매우 높은 할당률 (코어 꽉 쓰는 극단 부하)
- G1GC
- Throughput(RPS): 기준 100%
- 지연 avg 12ms / p99 60ms / p999 250ms
- GC puase: max 수백 ms ~ 수초
- ZGC
- Throughtput(RPS): G1 대비 -5~20%
- 지연: p99까지는 비슷한거만 낫지만 극단 할당에서는 오히려 분리해질 수 있음
- cpu 더 높아짐
- rss 더 증가
요약하면 할당률이 미친수준으로 높아지면 g1이 더 버티는 그림이 나올 수 있음.
이건 공개된 벤치에서도 방향이 같음
https://www.morling.dev/images/zgc_basic_latency_g1.png
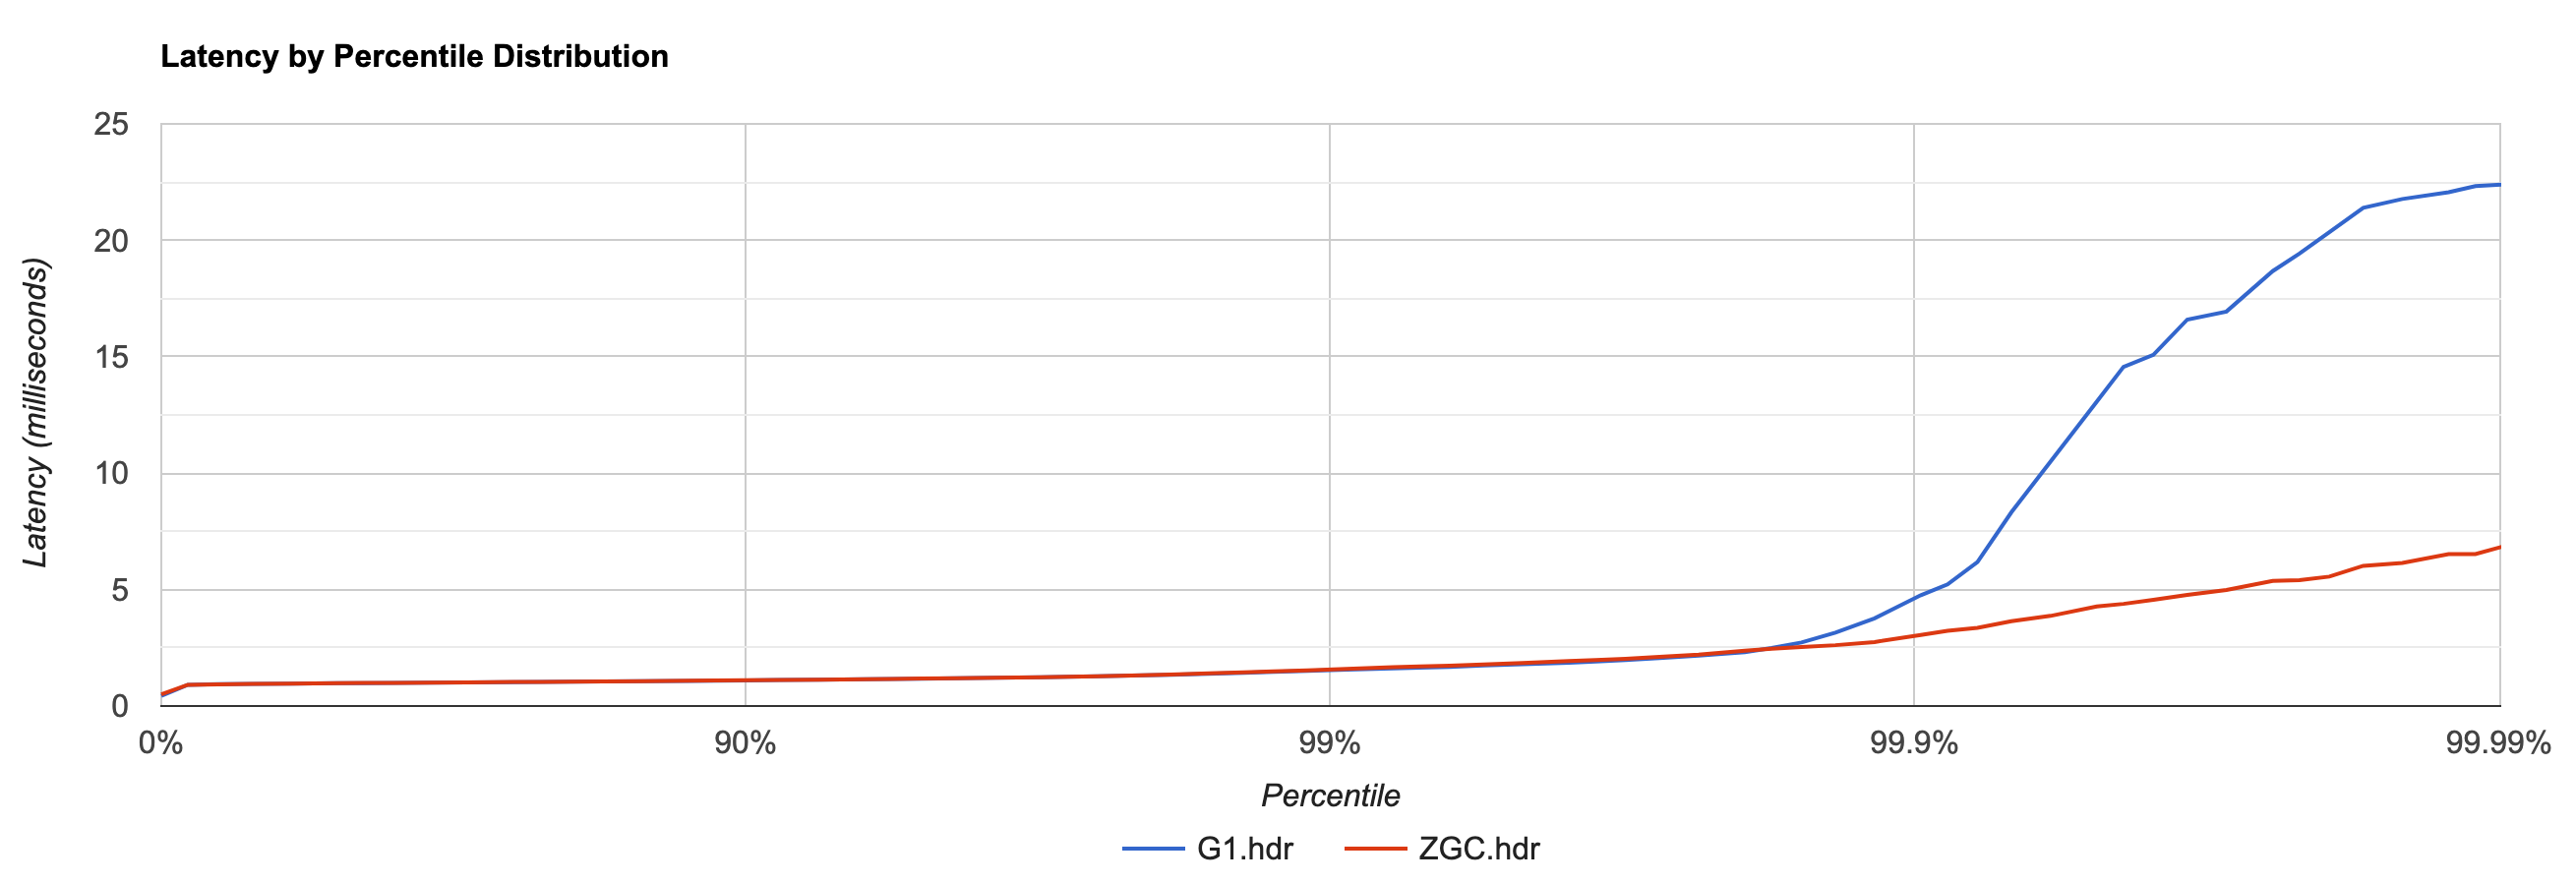
G1GC: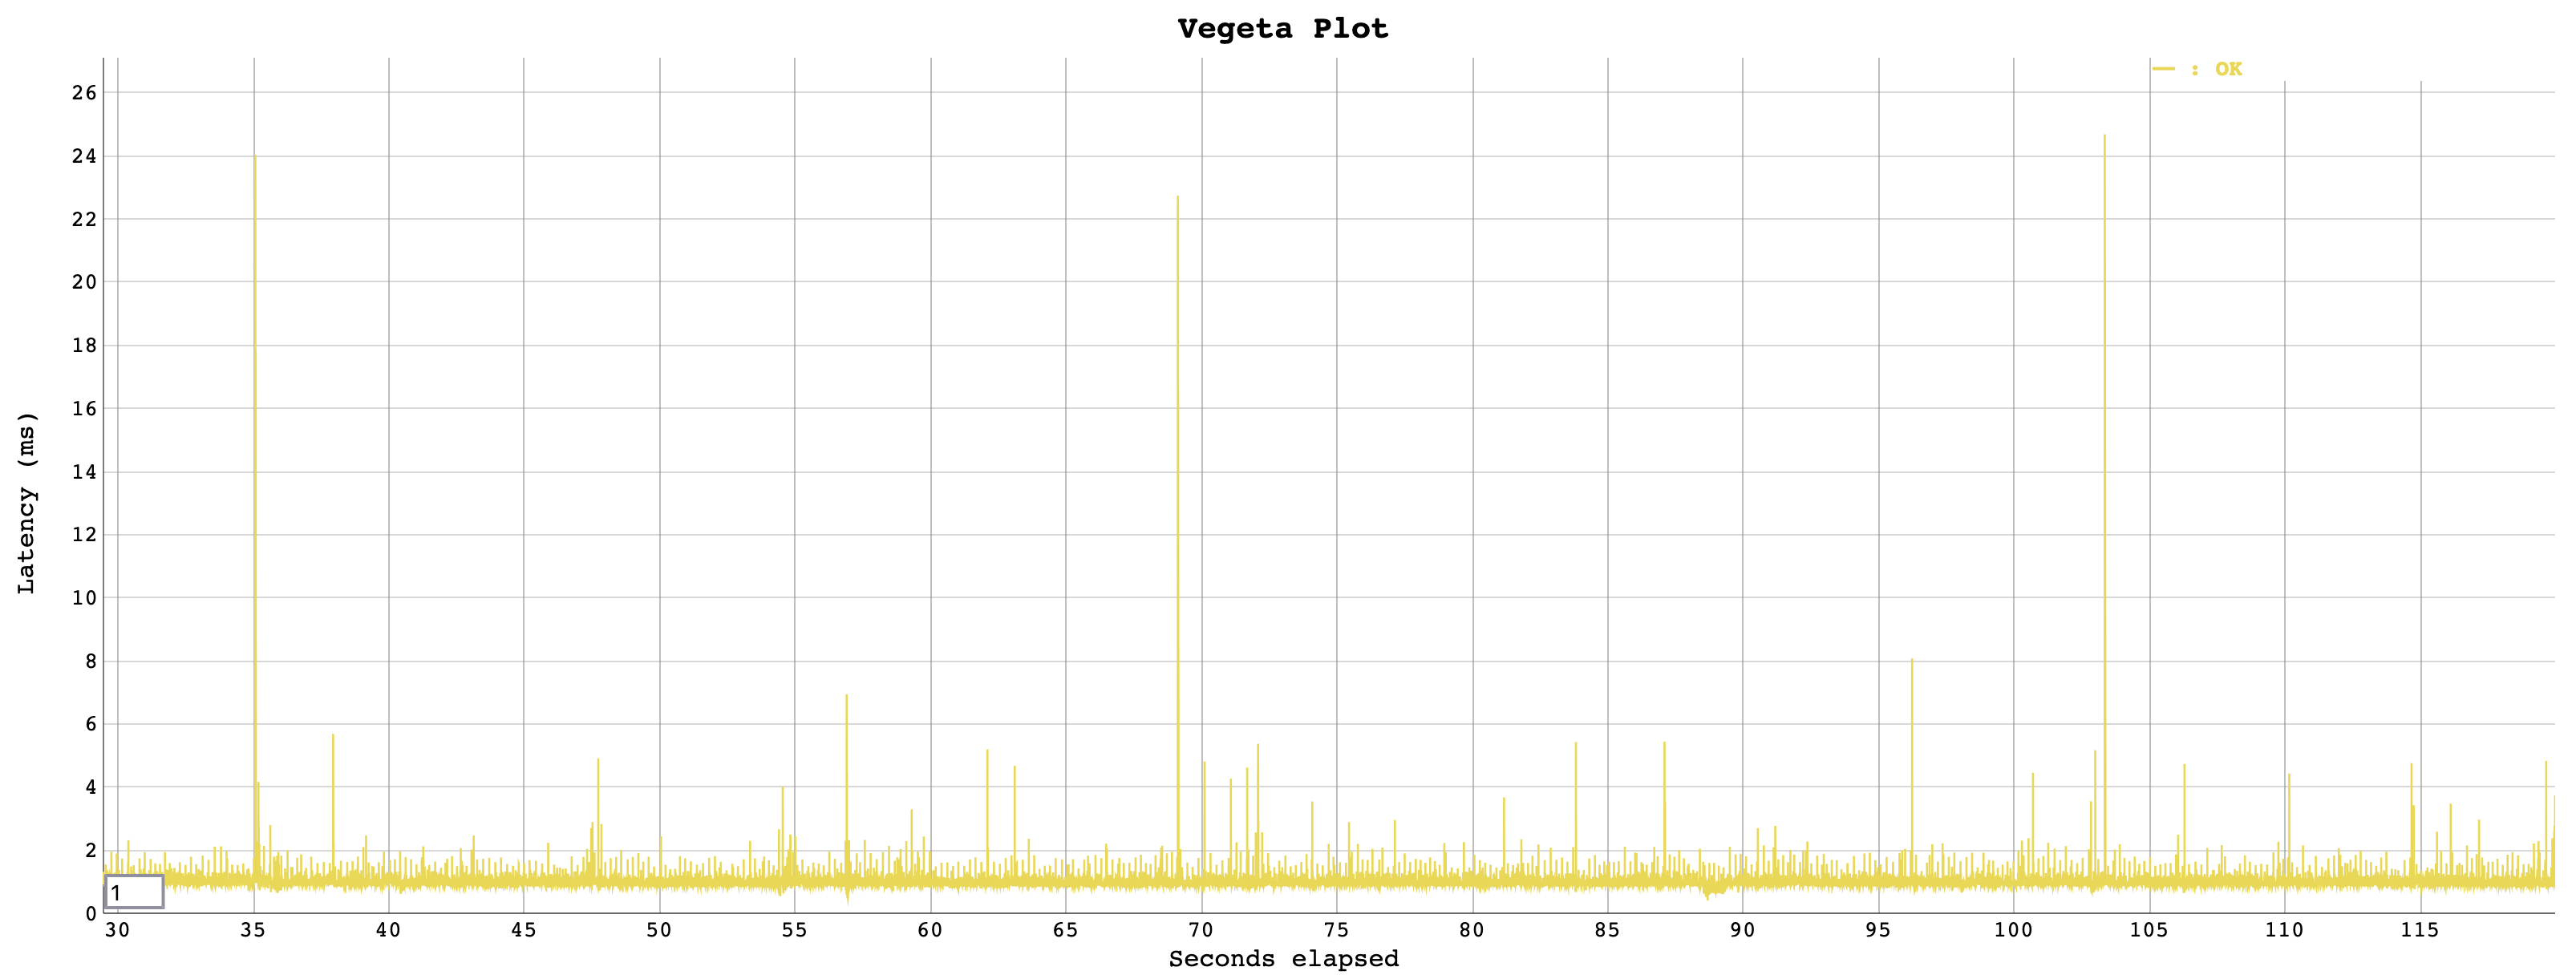
ZGC: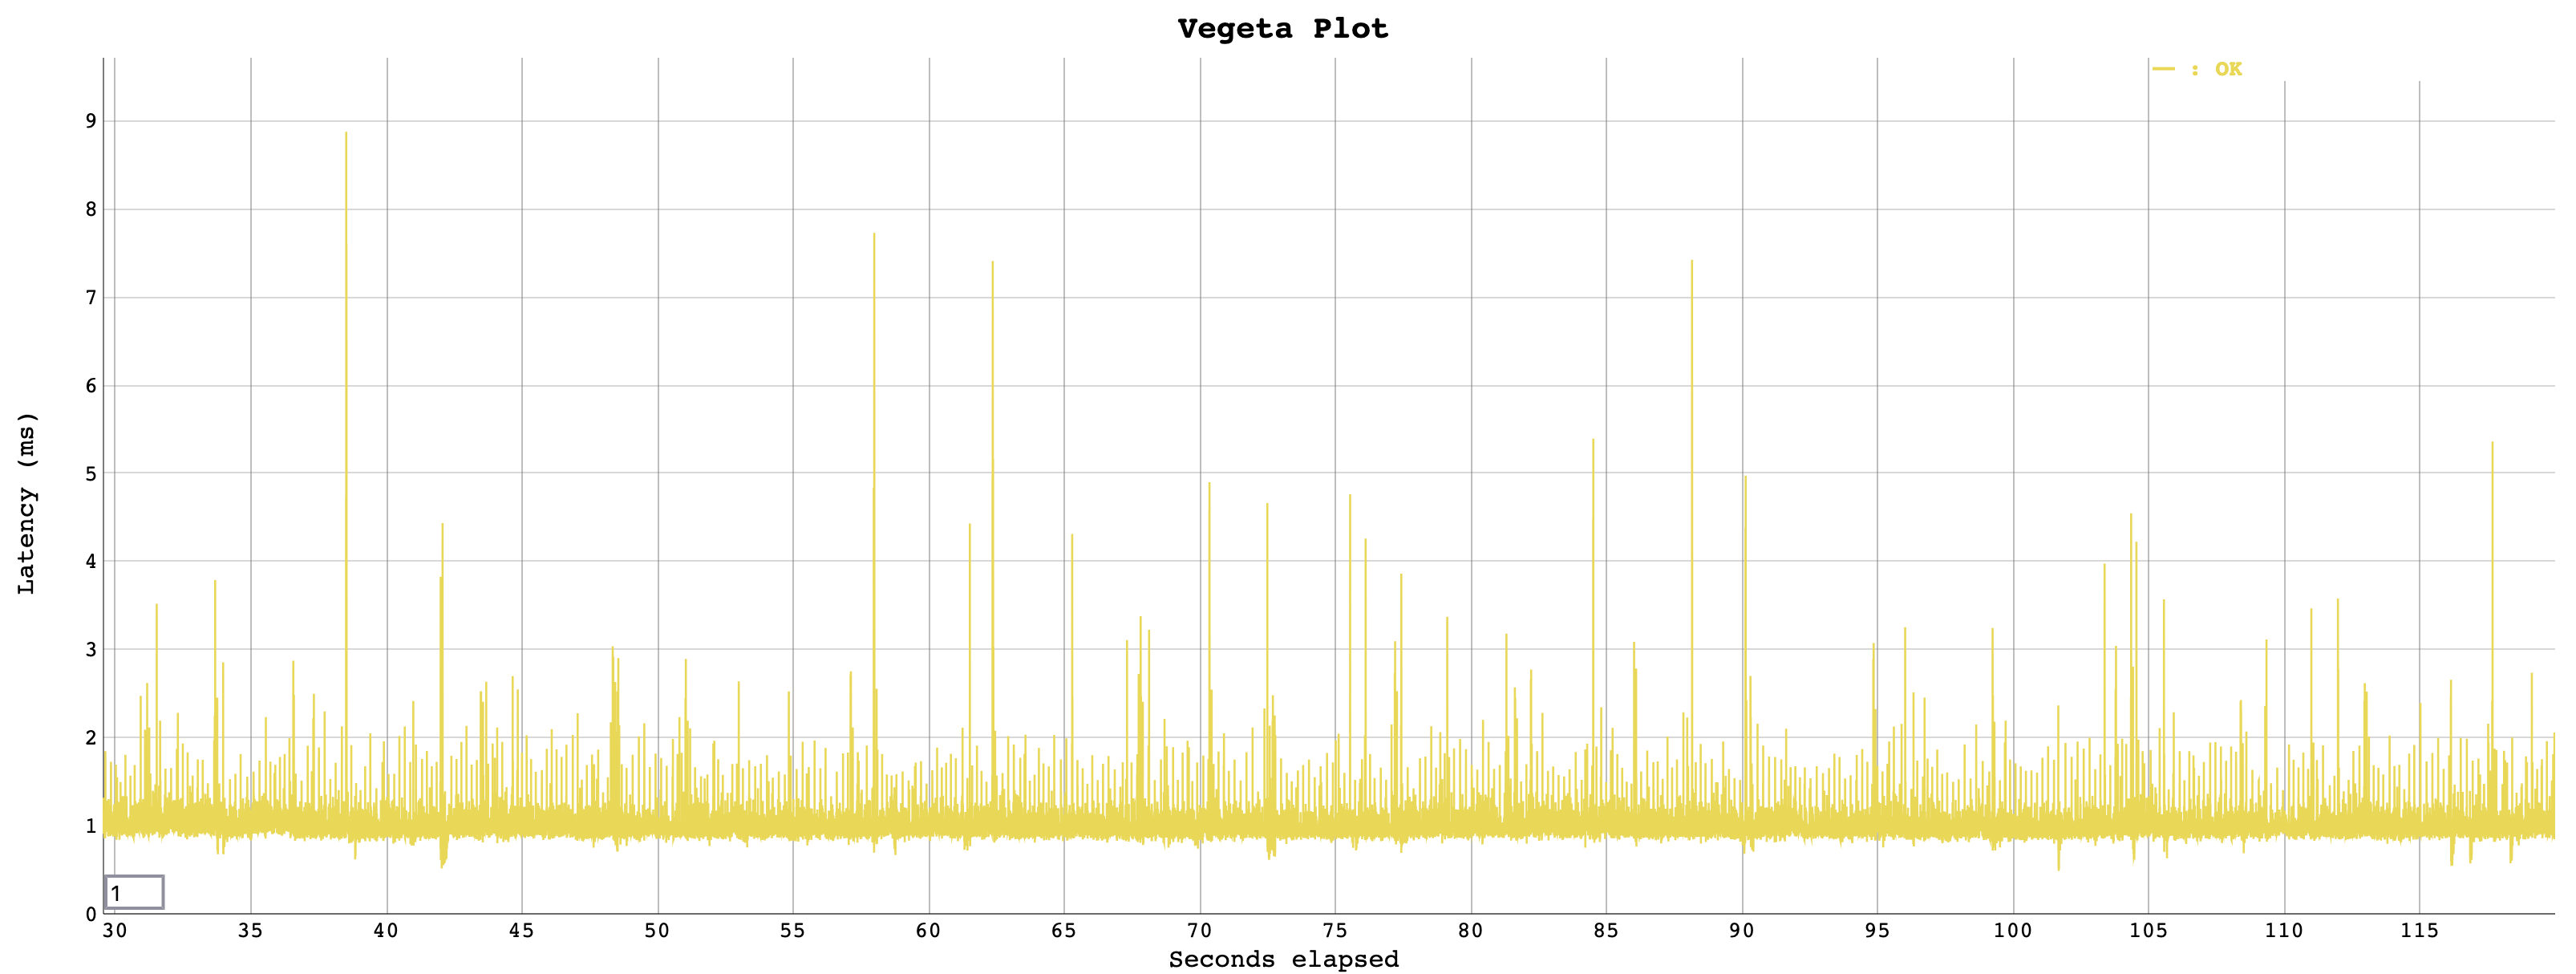
JDK 21 GC 로그는 -Xlog:gc*,safepoint:file=gc.log:time,level,tags 툴
JFR: -XX:StartFlightRecording=...
Prometheus JMX 서버 쓰고있고 부하도구는 k6
비교용 jvm 옵션 #
g1은 -XX:+UseG1GC, -XX:MaxGCPuaseMillis=200 (목표값임 이건 보장아님)
zgc는 -XX:+UseZGC
총총 #
서비스가 p999 끊김이 문제면 zgc가 유리한 경우가 많고, cpu가 항상 꽉 차고 할당률이 극단적이면 g1이 더 높은 처리량을 보일수도 있음.
+GenZGC는 tail latency를 개선을 노리는 사례가 많고 g1에서 긴 퍼즈가 관측되면 워크로드에서 개선 관찰이 보고되기도함.