깊이 우선 탐색(DFS)
DFS #
루트 노드에서 시작해서 다음 분기로 넘어가기 전에 해당 분기를 완벽하게 탐색하는 방법이다.
그래프 탐색이란 하나의 정점으로부터 시작해서 차례대로 모든 정점들을 한 번씩 방문하는 것이다.
예를 들어 특정 도시에서 다른 도시로 갈 수 있는지, 전자회로에서 특정 단자와 단자가 서로 연결되어 있는지를 탐색하는 알고리즘이다.
DFS에서의 노드 탐색 순서 #
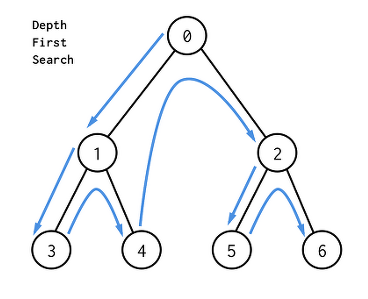
깊이 우선 탐색이기 때문에 한 방향으로 인접한 노드가 없을 때까지(가장 깊은 노드까지) 탐색한 뒤 다른 방향으로 탐색을 하는 방식이다.
DFS의 특징 #
- 모든 노드를 탐색해야 할 때 활용하기 좋은 방식이다.
- 깊이 우선 탐색(DFS)이 너비 우선 탐색(BFS)보다 좀 더 간단하다.
- 단순 검색 속도 자체는 너비 우선 탐색(BFS)에 비해서 느리다.
DFS 구현 알고리즘 #
- 루트노드에서 시작한다.
- 루트노드와 인접하고 방문된 적없는 노드를 방문한다.(가장 깊은 노드까지)
- 인접하고 방문된 적 없는 노드가 없을 경우(가장 깊은 노드를 방문한 뒤) 갈림길로 돌아와 다른 방향의 노드를 방문한다.
다음과 같은 순서를 따른다
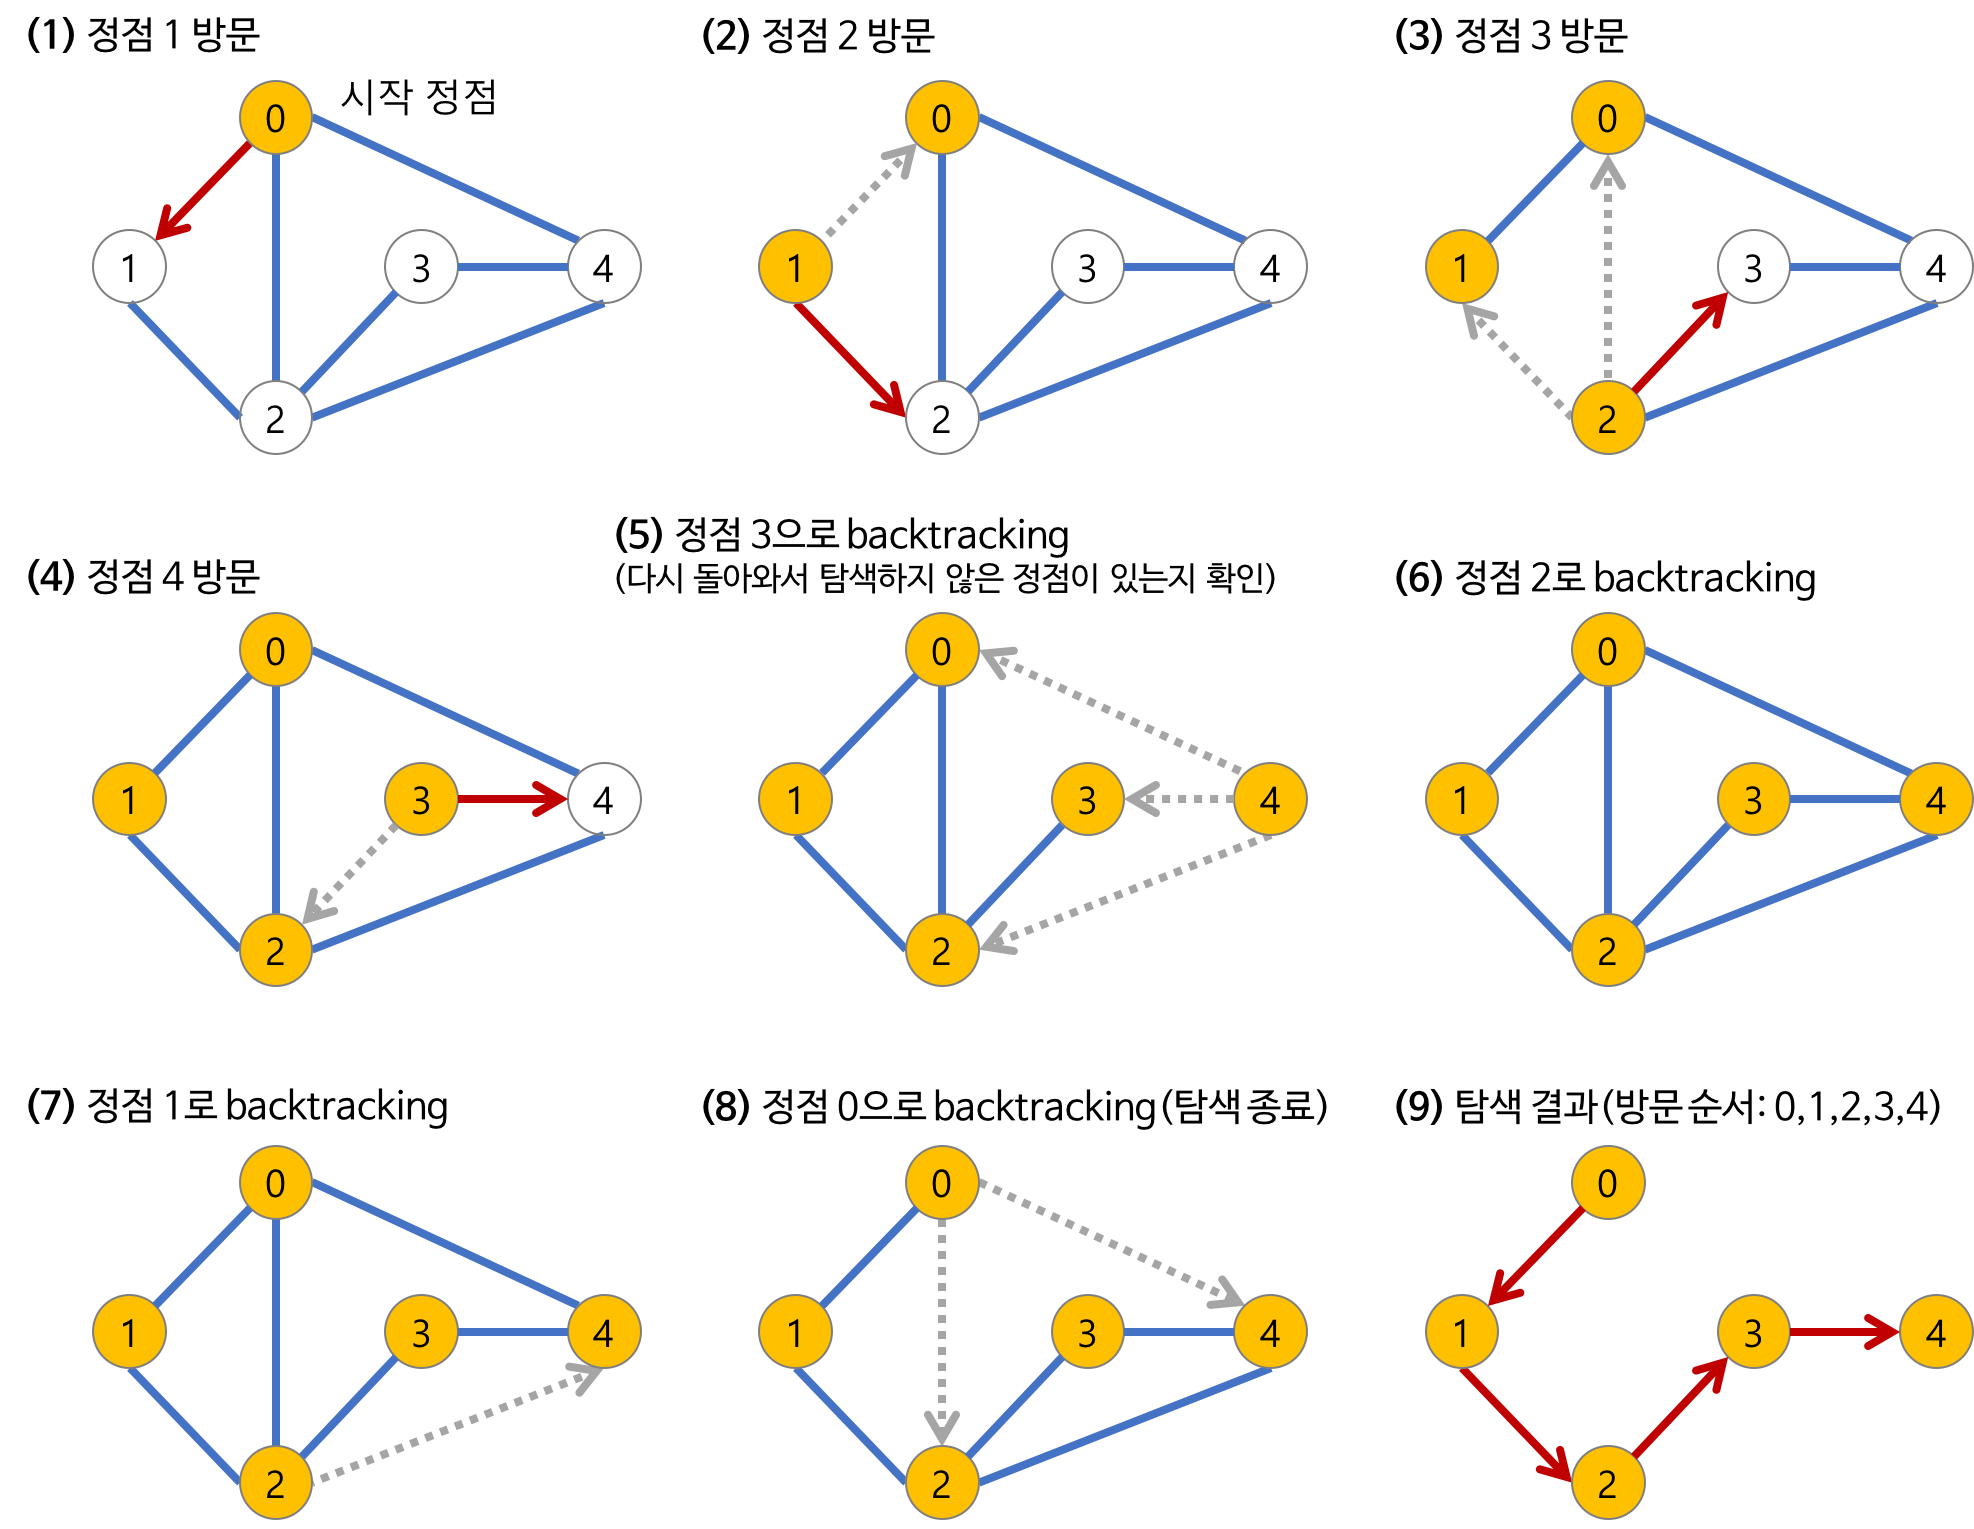
- 1번에서 루트노드에 방문학
- 2, 3, 4번에서 반복해서 인접하고, 방문된 적 없는 노드를 방문한다.
- 더 이상 인접하고, 방문된 적 없는 노드가 없는 경우 backtracking을 통해 다른 방향 즉 탐색하지 않는 노드를 찾는다.
그래프 구현 방식 #
- 인접 행렬
- 인접리스트
인접 행렬로 구현한 코드 #
- 인접행렬 배열(int[][] graph)
- 방문여부 배열(boolean[] visited)
- 방문한 노들르 순서대로 저장하는 배열(ArrayList visitedArr)
static void dfs(int node) {
    visited[node] = true;
    visitedArr.add(node);

    for(int i = 1; i <= nodeNum; i++){
        if(graph[node][i] == 1 && visited[i] == false) {
            dfs(i);
        }
    }
}
인접행렬로 구현한 DFS의 시간 복잡도: O(N^2)
DFS를 인접리스트로 구현한 코드 #
- 인접리스트 배열(ArrayList[] graph)
- 방문여부 배열(boolean[] visited)
- 방문한 노드를 순서대로 저장하는 배열 (ArrayList visitArr)
static void dfs(int node) {
    visited[node] = true;
    visitArr.add(node);

    for(int i = 0; i < graph[node].size(); i++) {
        int adjNode = graph[node].get(i);
        if(visited[adjNode] == false) {
            dfs(adjNode);
        }
    }
}