훈련 세트 스케일 문제
머신러닝 모델을 학습시킬 때 입력 데이터(feture)의 스케일 (크기 단위) 차이가 크면 다음과 같은 문제가 생긴다.
- 특정 feature 값이 지나치게 커서 거리 기반 알고리즘 KNN, SVM, 로지스틱 회귀, 신경망 등에서 해당 feature가 불균형하게 큰 영향을 미친다.
- 최적화 과정에서 경사 하강법에 대한 수렴 속도가 느려지며 학습 효율이 저하된다
- 가중치 해석이 왜곡된다 -> 모델 해석력이 떨어짐
예를 들어서 사과와 토마토를 분류하는 머신러닝 모델이 있다고 쳐보자. 길이와 무게로 분류할때 18cm, 100g은 토마토, 48cm, 800g 악마의열매 이런 느낌의 범위에 데이터들을 분류하는 모델에서 22cm, 200g 악마의열매로 분류되어야 할 것같다. 하지만 토마토로 분류되었다고 한다.
왜 토마토로 분류되었는지 살펴보기전에 산점도를 보게되면 아래와 같은 양상일거다.
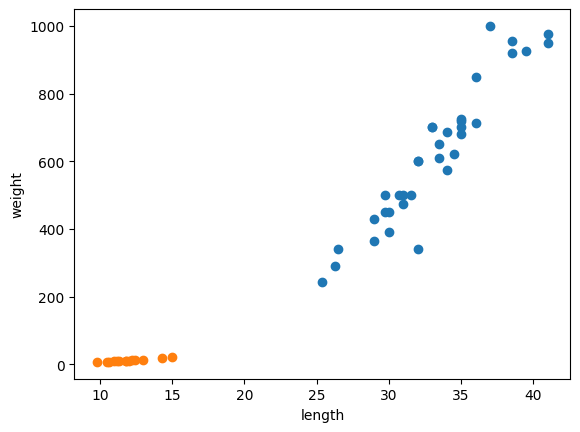
knn알고리즘은 인접한 데이터들을 참조해 가장 많은 빈도의 값으로 예측하는 알고리즘인데,
겉보기엔 인접한게 weight인것들 같지만, weight는 200단위로 오르는 반면에 length는 10단위로 그래프상에 표현되고있다. 그렇기에 그래프상에서는 더 가까워보이지만 실제로 계산할때는 토마토랑 훨신 가깝다는 얘기다.
스케일 문제 #
이는 훈련 세트의 x, y 데이터 세트의 스케일이 다르기 때문에 발생하는 문제다.
그렇기에 우리는 데이터 전처리를 통해 이 세트들의 데이터를 표준점수로 변환을 시켜줘야한다.
- 표준화: 평균 0 분산 1로 변환
- 정규화: 벡터 크기를 1로 맞춘다
- 로버스트 스케일링: 중앙값과 iqr(사분위 범위)를 활용한다.
이번엔 표준화를 통해서 데이터를 전처리하는 코드를 살펴보자
1. 분산 (Variance) #
2. 표본 분산 (Sample Variance) #
3. 표준편차 (Standard Deviation) #
데이터에서 평균을 뺀걸 제곱한거에서 다시 평균을 구하면 분산을 구할 수 있고 그거에 제곱근이 표준편차다.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score

# 1. 가상 데이터 생성 (무게, 색상 점수)
# 사과: 무게 가볍고 색 점수 낮음
# 토마토: 무게 조금 더 무겁고 색 점수 높음
np.random.seed(42)
apples = np.random.normal(loc=[120, 3], scale=[10, 1], size=(50, 2))  # (무게 120g, 색 점수 3)
tomatoes = np.random.normal(loc=[150, 7], scale=[10, 1], size=(50, 2))  # (무게 150g, 색 점수 7)

X = np.vstack([apples, tomatoes])
y = np.array([0]*50 + [1]*50)  # 0=사과, 1=토마토

# 2. 훈련/테스트 분리
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 3. 스케일링
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 모델 학습
model = LogisticRegression()
model.fit(X_train_scaled, y_train)

# 5. 예측 및 평가
y_pred = model.predict(X_test_scaled)
print("테스트 정확도:", accuracy_score(y_test, y_pred))

# 6. 시각화
plt.figure(figsize=(8,6))

# 원본 데이터 산점도
plt.scatter(X[y==0, 0], X[y==0, 1], color="red", label="사과")
plt.scatter(X[y==1, 0], X[y==1, 1], color="green", label="토마토")

# 결정 경계
xx, yy = np.meshgrid(
    np.linspace(X[:,0].min()-5, X[:,0].max()+5, 200),
    np.linspace(X[:,1].min()-1, X[:,1].max()+1, 200)
)
grid = np.c_[xx.ravel(), yy.ravel()]
grid_scaled = scaler.transform(grid)
Z = model.predict(grid_scaled).reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.2, cmap=plt.cm.RdYlGn)

plt.xlabel("무게(g)")
plt.ylabel("색 점수")
plt.legend()
plt.title("사과 vs 토마토 분류 (Logistic Regression + StandardScaler)")
plt.show()
TODO 사이킷런 함수 몇개 알아와야겠다.